Hindsight를 Docker로 운영하면서 LLM과 임베딩은 API를 쓰고, 리랭커는 로컬 NPU에서 실행하고 있다. 임베딩 API 비용은 낮아 로컬 운영의 필요성을 느끼지 않았고, 리랭커는 API 비용 부담 때문에 로컬을 선택했다.
Docker 기반 장기 기억 관리 시스템인 Hindsight를 단일보드 컴퓨터(ROCK 5C, RK3588 SoC, 8GB RAM) 환경에서 운영하면서, 워크로드의 특성에 따라 클라우드 API와 로컬 NPU를 분리하는 하이브리드 아키텍처를 적용했다. LLM과 임베딩은 상용 API로 처리하고, 검색 단계의 후보 재순위화(Reranking)는 로컬 NPU로 처리하도록 구성했다.
9개 완전한 UTC 날짜 동안 게이트웨이에 기록된 12,536건의 실측 트래픽과 하드웨어 벤치마크 데이터를 바탕으로, 이러한 분리 설계를 채택한 경제적·기술적 배경과 지연시간 트레이드오프를 정리한다.
목차
1. 하이브리드 아키텍처: LLM·임베딩 API와 로컬 NPU 리랭커의 분리 구성
Hindsight 환경에서 각 추론 작업을 분배한 기준은 자원 요구량과 API 과금 구조의 상호작용이다.
- 생성형 LLM: OpenCode Go를 통한 DeepSeek V4.1 Flash 클라우드 API를 사용한다. 월 구독 기반의 사용 한도 내에서 피크 시간대(입력 100만 토큰당 \(0.30, 출력\)1.20, 캐시 읽기 $0.006)와 비피크 시간대(50% 할인 적용) 요율로 계측된다.
- 텍스트 임베딩: Google Gemini Embedding 2(768차원) 클라우드 API를 사용한다.
- 문서 리랭커: 단일보드 하드웨어의 로컬 NPU(Rockchip RK3588, RKLLM 1.2.1)를 활용하여
Qwen3-Reranker-0.6B를 구동한다.
같은 보드에서의 모델 실행과 메모리 제약은 Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험와 RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과에서도 살펴봤다.
Hindsight와 상류 모델 간의 통신은 중앙 LLM 게이트웨이인 Bifrost(v2.2.4)를 통해 중계된다. 리랭커의 경우 상용 클라우드 API를 지속적으로 호출할 때 누적되는 단가 부담을 피하기 위해, Alibaba Cloud Qwen 팀이 공개한 Qwen3-Reranker-0.6B 모델을 커뮤니티(Hugging Face dulimov)에서 배포한 RK3588 전용 W8A8 양자화 형식(.rkllm)으로 변환된 산출물을 사용했다. 이 모델을 Docker Compose 격리 컨테이너에서 C++ 네이티브 로짓 브릿지(RKLLM_INFER_GET_LOGITS) 기반의 Cohere 호환 HTTP 서비스로 래핑하여 연결했다.
2. Bifrost 기록: 9일간의 요청과 비용 범위
Bifrost의 Hindsight 전용 가상 키 로그에서 2026년 10월 14일 00:00:00Z부터 2026년 10월 23일 00:00:00Z까지 9개 UTC 날짜를 조회했다. 아래 표는 이 범위에서 Gemini Embedding 2와 현행 DeepSeek V4.1 Flash의 성공 요청만 정리한 것이다.
| 프로바이더 및 모델 | 처리 성공 요청 수 | 프롬프트 토큰 | 완료 토큰 | 총 토큰 | Bifrost 기록액 (USD) |
|---|---|---|---|---|---|
gemini / gemini-embedding-2 |
9,484건 | 1,307,222 | 0 | 1,307,222 | $0.2614 |
opencode-go / deepseek-v4.1-flash |
889건 | 6,833,856 | 2,754,646 | 9,588,502 | $2.5412 |
두 금액은 게이트웨이에 설정한 단가로 계산한 기록액이다. Gemini도 실제 청구는 계정의 무료 사용 구간 등에 따라 달라질 수 있다.
첫째, OpenCode Go의 DeepSeek V4.1 Flash에 표기된 계측 금액($2.5412)은 서비스 사업자의 시간대별 요율표(피크 및 50% 비피크 할인)에 따라 게이트웨이가 토큰 사용 한도 관리를 위해 계산한 환산액이다. 이는 운영자의 실제 월 구독료 청구서 금액을 나타내는 것이 아니다.
둘째, Gemini 임베딩은 토큰과 비용 기록을 보완한 뒤의 로그를 사용했다. 이전에 누락된 기록을 무료 사용으로 계산하지 않았다.
셋째, 같은 관측 범위에서 로컬 Qwen 리랭커의 성공 요청은 731건이었다. 이 구성은 리랭킹을 위해 외부 종량제 API를 호출하지 않는다. 리랭커의 토큰 집계 누락을 토큰 사용량이 0이라는 뜻으로 해석하지 않았다.
전체 12,536건에는 초기 환경 구성, 부하 시험, 재시도, 백그라운드 작업과 과거 경유 경로도 포함돼 있다. 비용 기록이 빠진 경로까지 합쳐 전체 운영비를 계산하지 않았으며, 이 표를 일평균·월평균 또는 기억 저장·회상 한 건의 비용으로 외삽하지 않았다.
3. 임베딩을 클라우드 API로 유지한 이유: 130만 토큰에 0.26달러
Google의 공식 요금 정책에 따르면 Gemini Embedding 2의 텍스트 표준 유료 단가는 입력 100만 토큰당 \(0.20이다(비동기 Batch API는\)0.10이나, Hindsight의 동기식 파이프라인은 표준 요율이 적용된다).
9개 UTC일 동안 Hindsight가 기억 저장과 쿼리 처리를 위해 소비한 Gemini 프롬프트 토큰은 총 1,307,222개였다. 이를 공식 표준 단가로 계산하면 다음과 같다.
\[1,307,222 \times \frac{\$0.20}{1,000,000} = \$0.2614444\]표준 단가로 계산한 값은 $0.2614444다. 표의 $0.2614는 이를 반올림한 표시다. 이 관측 범위에서 9,484건의 임베딩 성공 요청에 대응하는 기록액은 약 0.26달러였다.
이 사용량에서는 임베딩 API 비용이 낮아 로컬 모델을 추가로 운영할 필요를 느끼지 못했다. 임베딩은 API로 유지하고, 로컬 자원과 운영 작업은 리랭커에 집중하기로 했다. 이는 현재 구성과 사용량에서 내린 판단이다.
4. 리랭커를 로컬로 내린 이유: Qwen3 RKLLM NPU 성능과 지연시간 실측
리랭커를 로컬로 옮긴 출발점은 API 비용 부담이었다. 현재 사용 환경에서는 Qwen의 검색 결과 품질에 만족하고 있어 계속 사용하고 있다. 특정 상용 리랭커의 요금과 직접 비교해 절감액을 계산한 것은 아니다.
로컬 리랭커 환경은 ROCK 5C 단일보드의 RK3588 NPU와 RKLLM 1.2.1 런타임을 사용했다. 커뮤니티에서 배포된 dulimov/Qwen3-Reranker-0.6B-rk3588-1.2.1 W8A8 양자화 모델을 올리고, C++ 네이티브 브릿지에서 RKLLM_INFER_GET_LOGITS를 호출하여 토크나이저의 yes/no 로짓에 소프트맥스를 적용해 점수를 산출한다. 컨텍스트 길이는 2048 토큰으로 제한하여 초과 시 422 오류를 반환하도록 안전장치를 두었다.
당시 시험에서 런타임 초기화는 파이썬 모듈 임포트를 제외하고 2.283초, 프로세스 최대 RSS는 1,437,372 KiB(약 1.371 GiB)로 관측됐다. 이 값은 해당 프로세스의 RSS이며 시스템 전체 메모리 사용량과는 다르다.
품질 검증을 위해 한국어 및 교차언어 질문-문서 쌍으로 구성된 12개의 수제 테스트 케이스를 대상으로 기존 CPU 기반 MiniLM(배치 크기 32)과 순위 정확도를 비교했다. Qwen3 NPU 모델은 12개 중 11개 쿼리에 대해 정답 문서를 1위로 랭킹(정답 1위 비율 11/12, MRR 0.9375)하여, MiniLM의 정답 1위 6개(정답 1위 비율 6/12, MRR 0.6417) 대비 높은 분별력을 보였다(단, 이 12개 테스트 케이스는 파이프라인 통합 점검용 프로브이며 공개 IR 벤치마크 점수를 보증하는 것은 아니다).
반면 추론 지연시간에서는 NPU 모델의 직렬 연산 구조로 인한 뚜렷한 한계가 확인되었다.
| 후보 문서 수 | MiniLM CPU (배치 크기 32) | Qwen3 RK3588 NPU (단일 직렬 추론) |
|---|---|---|
| 10개 | 0.372초 (3회 중앙값) | 5.047초 (3회 중앙값) |
| 30개 | 1.175초 (3회 중앙값) | 14.544초 (3회 중앙값) |
| 100개 | 4.411초 (1회 관측치) | 51.980초 (1회 관측치) |
| 300개 | 13.423초 (1회 관측치) | 114.537초 (1회 관측치) |
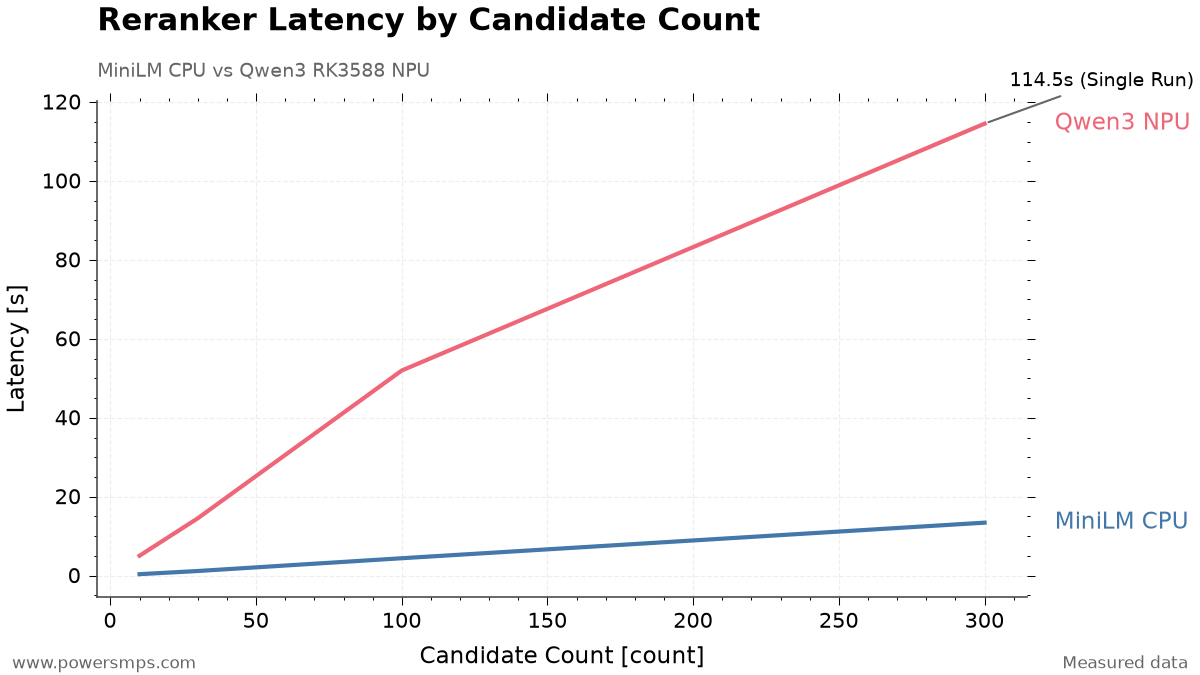
후보 수별 시험은 공유 호스트에서 48개의 짧은 문서를 반복해 구성했다. Qwen의 전체 프롬프트 입력은 평균 약 108토큰이었다. 각 구현의 프롬프트와 토크나이저를 사용했으며, MiniLM은 배치 32로 처리하고 Qwen은 후보를 직렬로 처리했다. 표의 결과는 이 두 구현을 시험한 관측값이다.
5. NPU 추론이 느려도 로컬 리랭커를 유지하는 실사용 운영 전략
100개 후보 처리에 52초가 소요되는 지연시간은 실시간 대화형 서비스 관점에서는 매우 긴 대기시간이다. 그럼에도 불구하고 이 구성을 프로덕션에서 유지하고 있는 배경에는 운영자의 실제 워크플로우 특성과 구체적인 최적화 설정이 있다.
실사용에서 속도 저하가 체감되지 않아 품질이 만족스러운 Qwen을 계속 쓰고 있다. 이는 현재 내 사용 환경에서의 평가다. 앞의 지연시간 측정값이 짧다는 의미로 일반화할 수는 없다.
시스템 안정성을 유지하기 위해 두 가지 핵심 운영 정책을 적용했다.
1) 사전 후보군 상한 50개 제한 정책
초기 설정에서는 최대 300개의 후보 문서를 리랭커로 전달했다. 실제 메모리 회상 시험에서 244개의 후보 문서가 전달되었을 때, 리랭킹에만 181.868초가 소요되어 전체 회상 시간이 183.612초에 달했다.
이에 Hindsight 설정에 HINDSIGHT_API_RERANKER_MAX_CANDIDATES=50을 적용하여 상호 순위 결합(RRF) 단계에서 상위 50개 후보만 리랭커로 전달하도록 제한했다. 동일 쿼리로 다시 측정한 결과, 리랭킹 처리시간은 104.259초로 42.67% 단축되었고, 전체 메모리 회상 소요시간은 105.791초로 42.38% 단축되었다. 서로 다른 입력과 측정 조건에서 나온 결과이므로 앞의 짧은 문서 시험과 지연시간을 직접 비교할 수는 없다.
| 동일 쿼리 단일 실행 비교 | 이전 설정 (최대 300개 허용, 실 244개 처리) | 상한 설정 (사전 상한 50개 적용, 실 50개 처리) |
|---|---|---|
| 평가된 후보 문서 수 | 244개 | 50개 |
| 리랭킹 처리시간 | 181.868초 | 104.259초 |
| 전체 메모리 회상 소요시간 | 183.612초 | 105.791초 |
| 최종 반환된 메모리 수 | 48개 | 44개 |
| 원본 출처 메모리 순위 | 1위 | 1위 |
후보 수가 244개에서 50개로 약 5분의 1로 줄었음에도 소요시간이 비례적으로 줄어들지 않은 것은, 프롬프트 캐시 재사용률과 단일보드 공유 호스트의 백그라운드 자원 경합 등 복합적인 요인이 작용한 것으로 추정되며, 후보 수에 따른 선형적 지연시간 확장을 성능 보증으로 간주해서는 안 된다. 후보군을 50개로 캡핑하는 것은 지연시간을 낮추는 대신 잠재적으로 관련 있는 메모리가 리랭킹 대상에서 사전 제외될 수 있는 상충관계를 수반한다.
2) 게이트웨이 직렬 큐잉과 다단계 타임아웃
로컬 워커가 한 번에 하나의 요청을 처리하도록 Bifrost의 리랭커 동시성을 1, 채널 버퍼를 10으로 설정했다. 현재 전역 정책에서 버퍼가 가득 차면 추가 요청도 기다릴 수 있으므로, 버퍼 10은 전체 대기 요청의 절대 상한을 뜻하지 않는다.
실제 합성 부하 시험(16개 문서 요청 1건 및 2개 문서 요청 10건 연속 유입)을 수행한 결과, 11건의 요청 모두 33.2~35.1초 범위 내에서 HTTP 200으로 정상 처리되었으며, NPU 워커 프로세스가 재시작 없이 안정적으로 재사용되었다.
또한 예기치 않은 NPU 정체를 방지하기 위해 다단계 타임아웃 마진을 구성했다.
- Hindsight 리랭커 타임아웃: 1800초 (30분)
- Bifrost 업스트림 소켓 타임아웃: 780초
- 로컬 C++ 네이티브 추론 타임아웃: 600초
- 네이티브 큐 대기 타임아웃: 120초
이러한 타임아웃 수치는 시스템의 정상 응답 속도가 아니라, 요청이 대기열에 머물거나 비정상적으로 지연될 때 안전하게 프로세스를 재기동하기 위한 안전 마진이다.
6. 운영 한계와 의사결정 기준: 단일보드 LLM 시스템의 워크로드 분배
로컬 리랭커를 유지할지는 API 비용과 결과 품질, 대기시간을 함께 보고 판단해야 한다. 현재 구성을 유지하는 이유와 그 한계는 다음과 같다.
KURE의 고정 256토큰 FP16 RKNN 모델도 시험했다. 동일한 50개 입력에서 HTTP 리랭크 응답시간은 KURE 10.647초, Qwen 27.798초였다. 다만 KURE에서는 2개 입력의 문서가 잘렸고, 별도 실제 회상 시험에서는 최종 순위도 달라졌다. 이 표본으로 두 모델의 전반적인 품질 우열을 단정할 수는 없다. 현재는 Qwen을 유지하고 있다.
둘째, 벤치마크 표본의 한계다. 본 운영에서 확인된 정답 1위 11/12(Top-1 적중률) 및 MRR 0.9375의 순위 성능은 서비스 배포를 위한 최소한의 파이프라인 점검용 프로브 결과일 뿐이며, 대규모 한국어 정보 검색(IR) 데이터셋에서의 일반적인 검색 성능을 대변하지 않는다.
이번 운영에서의 선택 기준은 다음과 같다.
- 임베딩: 현재 사용량에서는 API 비용이 낮아 로컬 운영의 필요성을 느끼지 못했다.
- 리랭커: API 비용 부담으로 로컬 Qwen을 선택했다. 품질에 만족하고 실사용에서 속도 저하가 체감되지 않아 유지하고 있다.
현재 사용량에서는 임베딩을 API로 유지할 이유가 충분했고, 리랭커는 비용과 품질을 보고 로컬로 유지할 이유가 있었다. 사용량이나 응답시간 요구가 달라지면 이 선택도 다시 검토할 수 있다.