제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.
목차
1. 분할한 DiT 블록을 다시 합칠 수 있을까
임베디드 NPU 환경에서 생성형 확산 모델(Diffusion Transformer)을 구동할 때, 런타임 메모리 제한과 연산자 지원 여부는 아키텍처 설계를 직접 결정짓는 핵심 요인이다. 이번 심화 실험은 2026년 8월 20일 Radxa ROCK 5C 8GB 단일 보드 컴퓨터 환경에서 진행되었다.
실험에는 직접 구매한 ROCK 5C 8GB 보드를 사용했다.
실험 보드는 RK3588S2 기반 ROCK 5C이며, RKNN 타깃은 rk3588이다. 같은 판매 페이지의 ROCK 5C Lite와 구분해야 한다.
1편의 Anima 구성은 28개 DiT 블록을 각각 attention·cross-attention·FFN으로 나눈 84개 FP16 RKNN 모델이다. AdaLN과 잔차 연결은 CPU에서 처리한다. 여기서는 블록당 3개 모델을 하나로 합칠 수 있는지 살펴봤다.
기존 파이프라인에서는 AdaLN(Adaptive LayerNorm) 연산과 잔차 연결(Residual Addition)을 호스트 CPU 파이썬 런타임에서 처리해 왔다. 그러나 단일 DiT 블록 내에서 3개의 서브그래프를 매 스텝마다 각각 로드·실행·해제하고 중간 결과를 CPU 호스트로 왕복시키는 구조는 상당한 드라이버 오버헤드를 발생시킨다. 만약 블록 내의 Self-Attention, Cross-Attention, FFN 및 AdaLN을 단일 RKNN 그래프로 융합(fused 1-model)할 수 있다면, 블록당 라이프사이클 호출 횟수를 3회에서 1회로 줄이고 호스트 텐서 전송 비용을 절감할 수 있을 것으로 기대되었다.
그러나 당시 기본 컴파일러로 사용하던 RKNN Toolkit 2.3.2 환경에서 AdaLN 연산자가 포함된 그래프를 컴파일할 때 치명적인 컴파일러 세그멘테이션 폴트(SIGSEGV, exit code 139)가 발생했다. 이 크래시가 Anima DiT 구조 자체의 근본적인 하드웨어 비지원인지, 컴파일러 버그인지 검증하는 작업이 선행되어야 했다.
2. 같은 AdaLN 그래프를 다른 툴킷으로 빌드하기
컴파일러 충돌 문제를 분석하기 위해, 거대한 전체 DiT 블록 대신 충돌을 유발하는 AdaLN 연산자만 격리한 최소 재현용 ONNX 모델(Minimal AdaLN reproducer)을 추출하여 컴파일 실험을 수행했다.
같은 AdaLN 재현 그래프를 RKNN Toolkit 2.3.2와 2.3.0으로 각각 빌드했다. 다른 조건은 유지하고 컴파일러 버전에 따른 결과를 비교했다.
동일한 reproducer ONNX 모델, 동일한 타깃(rk3588), 동일한 단일 코어 최적화 옵션에서 측정된 빌드 결과는 다음과 같다.
| 툴킷 버전 | AdaLN 그래프 빌드 | 종료 코드 |
|---|---|---|
| 2.3.2 | 실패: SIGSEGV | 139 |
| 2.3.0 | 성공 | 0 |
2.3.2에서는 LayerNorm 관련 그래프 최적화 뒤 SIGSEGV로 빌드가 중단됐다. 2.3.0에서는 같은 그래프가 정상적으로 빌드됐다.
동일한 입력 그래프와 타깃에서 버전에 따라 결과가 달라져, 이번 실패는 컴파일러 회귀 문제로 판단했다. 이전 버전인 2.3.0이 이번 그래프의 회피 경로가 되었으며, 새 버전으로 올려 해결한 사례는 아니다.
3. 64px·512px 융합 모델 실행 확인
Toolkit 2.3.0으로 첫 번째 DiT 블록의 융합 모델을 빌드했다. 64px 테스트 구성과 512px 실제 추론 구성을 나누어 확인했다.
| 융합 블록 해상도 | RKNN 변환 | 보드에서 실행 |
|---|---|---|
| 64px | 성공 | 초기화·추론 확인 |
| 512px | 성공 | 초기화·추론·해제 확인 |
512px 모델 빌드는 스왑 없이 완료됐다. 일부 Transpose와 Erf 연산은 CPU로 배치되었으므로, 단일 RKNN 파일로 합쳤다고 해서 모든 연산이 NPU에서 실행되는 것은 아니다.
더 중요한 검증 포인트는 타깃 보드 로컬 런타임과의 바이너리 호환성이었다. 컴파일러를 2.3.0으로 빌드했더라도 보드 OS의 RKNPU 커널 드라이버나 런타임 라이브러리를 강제로 교체해야 한다면 배포 복잡도가 급격히 상승한다.
빌드한 모델은 런타임 API 2.3.0·드라이버 0.9.8 환경에서 실행했다. 커널이나 드라이버를 교체하지 않고 로드·초기화·추론·해제를 확인했으며, 조건부·무조건부 추론을 3라운드 반복했다.
이번 단일 블록 검증에서는 컴파일러 환경만 바꾸어도 기존 보드 런타임에서 실행할 수 있었다.
4. 단일 블록 출력의 수치 차이
융합 모델의 하드웨어 실행이 확인된 후, NPU 융합 연산 결과가 원본 부동소수점 기준 텐서와 수치적으로 일치하는지 단일 블록 수치 검증(Correctness Gate)을 수행했다. 기준 참조 텐서는 PyTorch FP16 원본 블록 연산 결과와 ONNX Runtime(ORT) 결과다.
| 대상 아키텍처 | 기준 참조 텐서 (Reference) | 코사인 유사도 (Cosine) | 최대 절대 오차 (Max Abs) | 평균 절대 오차 (Mean Abs) | 평균 제곱 오차 (MSE) | NaN/Inf 검출 |
|---|---|---|---|---|---|---|
| 64px Fused | PyTorch | 0.99998315 | 0.28125 | 0.0018879 | 4.2748e-05 | 0 / 0 |
| 64px Fused | ONNX Runtime | 0.99998608 | 0.28125 | 0.0018948 | 3.5387e-05 | 0 / 0 |
| 512px Split (기존) | PyTorch | 0.99999881 | 0.14937 | 0.0002283 | 1.0841e-06 | 0 / 0 |
| 512px Fused (후보) | PyTorch | 0.99997673 | 0.25000 | 0.0011279 | 2.1100e-05 | 0 / 0 |
| 512px Fused (후보) | ONNX Runtime | 0.99997590 | 0.28906 | 0.0011662 | 2.1854e-05 | 0 / 0 |
512px 융합 모델은 PyTorch 기준 출력과의 코사인 유사도 0.99997673, 최대 절대 오차 0.25000을 기록했고 NaN과 Inf는 발생하지 않았다.
다만 융합 모델의 MSE는 2.1100e-05로, 기존 분할 방식의 1.0841e-06보다 약 19.5배 컸다. 단일 블록의 높은 코사인 유사도만으로는 전체 28개 블록과 여러 스텝을 거친 최종 이미지의 화질까지 확인할 수 없다.
5. 호출은 줄었지만 속도 이득은 0.47%
서브그래프 융합을 추진했던 가장 핵심적인 목적은 지연 시간 단축이었다. 호스트 파이썬에서 실행되던 AdaLN 및 잔차 연산을 컴파일된 그래프 내부로 옮기고 드라이버 컨텍스트 호출 횟수를 줄임으로써 속도 향상을 기대했다.
ROCK 5C 보드에서 512px 단일 블록에 대해 CFG(Classifier-Free Guidance) 2회 연산 스트림을 3라운드 실행하고, 각 단계별 소요 시간의 평균치를 정밀 계측했다.
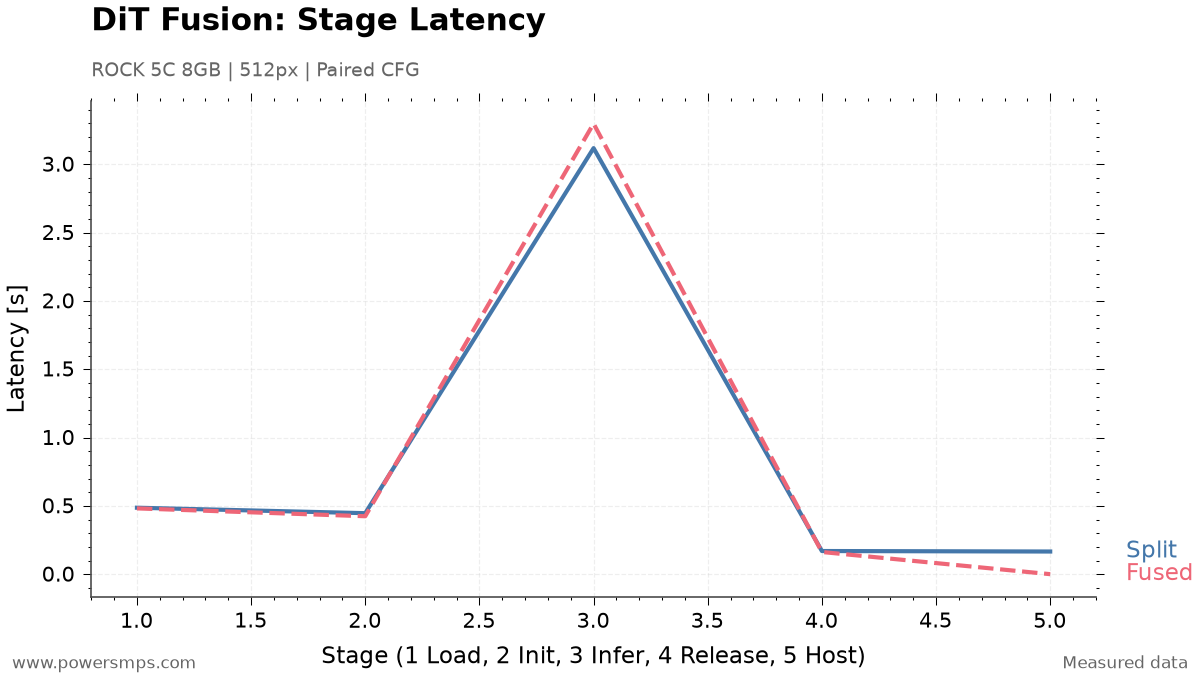
아래 표는 기존 3-model 분할 방식과 Fused 1-model 방식의 단계별 실측 수치 비교다.
| 실행 단계 및 구성요소 | 기존 3-Model Split | Fused 1-Model 후보 | Fused 변동량 | 변동 원인 및 분석 |
|---|---|---|---|---|
| Model Load | 0.4863초 | 0.4814초 | -0.0049초 | 가중치 파일 로딩 시간 (단일 블록 기준 미미한 단축) |
| Runtime Init | 0.4464초 | 0.4240초 | -0.0224초 | NPU 런타임 컨텍스트 초기화 시간 소폭 단축 |
| NPU Inference (×2) | 3.1177초 | 3.2972초 | +0.1795초 (+5.76%) | 연산자 융합에 따른 NPU 실행 지연 발생 |
| Context Release | 0.1694초 | 0.1623초 | -0.0071초 | 컨텍스트 메모리 해제 시간 |
| Host AdaLN & Residual | 0.1658초 | 0.0000초 | -0.1658초 (-100%) | 별도 Python 호스트 AdaLN 경로 제거 |
| 순수 구성요소 합계 | 4.3856초 | 4.3650초 | -0.0206초 (-0.47%) | 실제 획득된 순수 단축 시간은 0.0206초에 불과 |
| 계측 Wall Time | 4.7379초 | 4.4981초 | -0.2398초 (-5.06%) | 분할 모드의 다중 메모리 스냅샷 계측 왜곡치 포함 |
실측 데이터는 직관적인 예상과 상반된 병목 현상을 보여주었다.
첫째, 호스트 연산 시간인 0.1658초는 Fused 모델에서 완전히 0초로 제거되었다. 그러나 NPU의 순수 순방향 추론 시간(Inference ×2)이 기존 3.1177초에서 3.2972초로 +0.1795초(+5.76%) 증가했다. 융합 구성에서 추론 시간이 늘어나면서, 호스트 연산 제거로 얻은 이득(0.1658초)을 완전히 상쇄했다.
둘째, 컨텍스트 호출 횟수는 3회에서 1회로 66.7% 줄어들었으나, 수명주기(Load, Init, Release) 오버헤드는 기대만큼 줄어들지 않았다. 단일 블록의 수명주기 총 시간은 기존 1.1021초에서 1.0678초로 3.1% 단축되는 데 그쳤다. RKNPU 드라이버의 실제 초기화 및 로드 오버헤드는 단순한 C API 호출 횟수보다 모델 파일의 전체 가중치 용량(약 140~155 MB)과 그래프 복잡도에 지배된다는 사실이 드러났다.
셋째, 계측된 Wall Time상으로는 0.2398초(5.06%)가 줄어든 것처럼 관측되지만, 이는 분할 모드에서 3개의 서브 컨텍스트마다 디버깅용 메모리 스냅샷을 6회 반복 수집한 계측 오버헤드가 포함된 수치다. 스냅샷 계측 왜곡을 배제한 순수 구성요소 합계 기준 실제 단축 효과는 블록당 0.0206초(-0.47%)에 불과했다.
6. NPU 디바이스 매핑은 94.30 MiB 증가
지연 시간 단축 효과가 미미한 반면, 런타임 메모리 측면에서는 심각한 손실이 발생했다. 보드 레벨에서 계측된 메모리 지표는 다음과 같다.
| 메모리 측정 지표 | 기존 3-Model Split | Fused 1-Model 후보 | 차이 및 증감률 |
|---|---|---|---|
| NPU 디바이스 매핑 디바이스 PSS | 127,144 KiB | 223,704 KiB | +96,560 KiB (+94.30 MiB, +75.9%) |
| 실행 시 피크 프로세스 PSS | 648,282 KiB | 694,882 KiB | +46,600 KiB (+45.51 MiB, +7.2%) |
| 신규 시스템 스왑(Swap) 발생량 | 0 | 0 | 0 (단일 블록 기준 안전) |
분할 방식은 각 브랜치를 순서대로 실행한 뒤 해제한다. 한 번에 유지하는 NPU 디바이스 매핑의 피크는 127,144 KiB, 약 124.16 MiB였다.
융합 방식은 블록 전체를 하나의 런타임 컨텍스트로 유지한다. 디바이스 매핑은 223,704 KiB, 약 218.46 MiB로 늘어 추가로 94.30 MiB를 차지했다.
총 8GB의 LPDDR4X 메모리를 공유하는 ROCK 5C 환경에서, 백그라운드 OS와 텍스트 인코더, VAE가 공존해야 하는 상황에 디바이스 매핑 메모리가 75.9%나 급증하는 것은 심각한 시스템 압박 요인이다.
7. 융합을 채택하지 않은 이유
단일 블록의 차이를 전체 구성에 외삽한 예상 절감량은 약 7.51초였다. 이는 전체 이미지 생성을 실행해 측정한 결과가 아니다.
- 속도: 호스트 연산을 줄인 이득이 NPU 추론 지연 증가로 대부분 상쇄됐다.
- 메모리: 같은 블록을 실행하는 데 필요한 디바이스 매핑이 늘었다.
- 정밀도: 단일 블록의 코사인 유사도는 높았지만 MSE는 기존 분할 방식보다 커졌다.
속도 이득은 0.47%에 그쳤고 메모리 사용량은 늘었으므로, 이번 보드에서는 기존 분할 방식을 유지했다.
검증 범위는 단일 블록에 한정된다. 전체 28개 블록을 융합해 이미지를 생성하는 실험이나 장시간 운용 검증까지 진행한 결과는 아니다.
3편의 상주 실험과 이번 융합 실험 모두, 호출 횟수를 줄이는 것만으로는 전체 성능을 설명할 수 없었다. NPU 연산 시간과 메모리 비용까지 함께 비교해야 8GB 보드에서 실제로 쓸 수 있는 최적화를 고를 수 있다.