[태그:] ROCK 5C

  • Hindsight 운영 비용: 임베딩은 API, 리랭커는 로컬을 선택한 이유

    Hindsight 운영 비용: 임베딩은 API, 리랭커는 로컬을 선택한 이유

    Hindsight를 Docker로 운영하면서 LLM과 임베딩은 API를 쓰고, 리랭커는 로컬 NPU에서 실행하고 있다. 임베딩 API 비용은 낮아 로컬 운영의 필요성을 느끼지 않았고, 리랭커는 API 비용 부담 때문에 로컬을 선택했다.

    Docker 기반 장기 기억 관리 시스템인 Hindsight를 단일보드 컴퓨터(ROCK 5C, RK3588 SoC, 8GB RAM) 환경에서 운영하면서, 워크로드의 특성에 따라 클라우드 API와 로컬 NPU를 분리하는 하이브리드 아키텍처를 적용했다. LLM과 임베딩은 상용 API로 처리하고, 검색 단계의 후보 재순위화(Reranking)는 로컬 NPU로 처리하도록 구성했다.

    9개 완전한 UTC 날짜 동안 게이트웨이에 기록된 12,536건의 실측 트래픽과 하드웨어 벤치마크 데이터를 바탕으로, 이러한 분리 설계를 채택한 경제적·기술적 배경과 지연시간 트레이드오프를 정리한다.


    1. 하이브리드 아키텍처: LLM·임베딩 API와 로컬 NPU 리랭커의 분리 구성

    Hindsight 환경에서 각 추론 작업을 분배한 기준은 자원 요구량과 API 과금 구조의 상호작용이다.

    • 생성형 LLM: OpenCode Go를 통한 DeepSeek V4.1 Flash 클라우드 API를 사용한다. 월 구독 기반의 사용 한도 내에서 피크 시간대(입력 100만 토큰당 \(0.30, 출력\)1.20, 캐시 읽기 $0.006)와 비피크 시간대(50% 할인 적용) 요율로 계측된다.
    • 텍스트 임베딩: Google Gemini Embedding 2(768차원) 클라우드 API를 사용한다.
    • 문서 리랭커: 단일보드 하드웨어의 로컬 NPU(Rockchip RK3588, RKLLM 1.2.1)를 활용하여 Qwen3-Reranker-0.6B를 구동한다.

    같은 보드에서의 모델 실행과 메모리 제약은 Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험와 RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과에서도 살펴봤다.

    Hindsight와 상류 모델 간의 통신은 중앙 LLM 게이트웨이인 Bifrost(v2.2.4)를 통해 중계된다. 리랭커의 경우 상용 클라우드 API를 지속적으로 호출할 때 누적되는 단가 부담을 피하기 위해, Alibaba Cloud Qwen 팀이 공개한 Qwen3-Reranker-0.6B 모델을 커뮤니티(Hugging Face dulimov)에서 배포한 RK3588 전용 W8A8 양자화 형식(.rkllm)으로 변환된 산출물을 사용했다. 이 모델을 Docker Compose 격리 컨테이너에서 C++ 네이티브 로짓 브릿지(RKLLM_INFER_GET_LOGITS) 기반의 Cohere 호환 HTTP 서비스로 래핑하여 연결했다.


    2. Bifrost 기록: 9일간의 요청과 비용 범위

    Bifrost의 Hindsight 전용 가상 키 로그에서 2026년 10월 14일 00:00:00Z부터 2026년 10월 23일 00:00:00Z까지 9개 UTC 날짜를 조회했다. 아래 표는 이 범위에서 Gemini Embedding 2와 현행 DeepSeek V4.1 Flash의 성공 요청만 정리한 것이다.

    프로바이더 및 모델 처리 성공 요청 수 프롬프트 토큰 완료 토큰 총 토큰 Bifrost 기록액 (USD)
    gemini / gemini-embedding-2 9,484건 1,307,222 0 1,307,222 $0.2614
    opencode-go / deepseek-v4.1-flash 889건 6,833,856 2,754,646 9,588,502 $2.5412

    두 금액은 게이트웨이에 설정한 단가로 계산한 기록액이다. Gemini도 실제 청구는 계정의 무료 사용 구간 등에 따라 달라질 수 있다.

    첫째, OpenCode Go의 DeepSeek V4.1 Flash에 표기된 계측 금액($2.5412)은 서비스 사업자의 시간대별 요율표(피크 및 50% 비피크 할인)에 따라 게이트웨이가 토큰 사용 한도 관리를 위해 계산한 환산액이다. 이는 운영자의 실제 월 구독료 청구서 금액을 나타내는 것이 아니다.

    둘째, Gemini 임베딩은 토큰과 비용 기록을 보완한 뒤의 로그를 사용했다. 이전에 누락된 기록을 무료 사용으로 계산하지 않았다.

    셋째, 같은 관측 범위에서 로컬 Qwen 리랭커의 성공 요청은 731건이었다. 이 구성은 리랭킹을 위해 외부 종량제 API를 호출하지 않는다. 리랭커의 토큰 집계 누락을 토큰 사용량이 0이라는 뜻으로 해석하지 않았다.

    전체 12,536건에는 초기 환경 구성, 부하 시험, 재시도, 백그라운드 작업과 과거 경유 경로도 포함돼 있다. 비용 기록이 빠진 경로까지 합쳐 전체 운영비를 계산하지 않았으며, 이 표를 일평균·월평균 또는 기억 저장·회상 한 건의 비용으로 외삽하지 않았다.


    3. 임베딩을 클라우드 API로 유지한 이유: 130만 토큰에 0.26달러

    Google의 공식 요금 정책에 따르면 Gemini Embedding 2의 텍스트 표준 유료 단가는 입력 100만 토큰당 \(0.20이다(비동기 Batch API는\)0.10이나, Hindsight의 동기식 파이프라인은 표준 요율이 적용된다).

    9개 UTC일 동안 Hindsight가 기억 저장과 쿼리 처리를 위해 소비한 Gemini 프롬프트 토큰은 총 1,307,222개였다. 이를 공식 표준 단가로 계산하면 다음과 같다.

    \[1,307,222 \times \frac{\$0.20}{1,000,000} = \$0.2614444\]

    표준 단가로 계산한 값은 $0.2614444다. 표의 $0.2614는 이를 반올림한 표시다. 이 관측 범위에서 9,484건의 임베딩 성공 요청에 대응하는 기록액은 약 0.26달러였다.

    이 사용량에서는 임베딩 API 비용이 낮아 로컬 모델을 추가로 운영할 필요를 느끼지 못했다. 임베딩은 API로 유지하고, 로컬 자원과 운영 작업은 리랭커에 집중하기로 했다. 이는 현재 구성과 사용량에서 내린 판단이다.


    4. 리랭커를 로컬로 내린 이유: Qwen3 RKLLM NPU 성능과 지연시간 실측

    리랭커를 로컬로 옮긴 출발점은 API 비용 부담이었다. 현재 사용 환경에서는 Qwen의 검색 결과 품질에 만족하고 있어 계속 사용하고 있다. 특정 상용 리랭커의 요금과 직접 비교해 절감액을 계산한 것은 아니다.

    로컬 리랭커 환경은 ROCK 5C 단일보드의 RK3588 NPU와 RKLLM 1.2.1 런타임을 사용했다. 커뮤니티에서 배포된 dulimov/Qwen3-Reranker-0.6B-rk3588-1.2.1 W8A8 양자화 모델을 올리고, C++ 네이티브 브릿지에서 RKLLM_INFER_GET_LOGITS를 호출하여 토크나이저의 yes/no 로짓에 소프트맥스를 적용해 점수를 산출한다. 컨텍스트 길이는 2048 토큰으로 제한하여 초과 시 422 오류를 반환하도록 안전장치를 두었다.

    당시 시험에서 런타임 초기화는 파이썬 모듈 임포트를 제외하고 2.283초, 프로세스 최대 RSS는 1,437,372 KiB(약 1.371 GiB)로 관측됐다. 이 값은 해당 프로세스의 RSS이며 시스템 전체 메모리 사용량과는 다르다.

    품질 검증을 위해 한국어 및 교차언어 질문-문서 쌍으로 구성된 12개의 수제 테스트 케이스를 대상으로 기존 CPU 기반 MiniLM(배치 크기 32)과 순위 정확도를 비교했다. Qwen3 NPU 모델은 12개 중 11개 쿼리에 대해 정답 문서를 1위로 랭킹(정답 1위 비율 11/12, MRR 0.9375)하여, MiniLM의 정답 1위 6개(정답 1위 비율 6/12, MRR 0.6417) 대비 높은 분별력을 보였다(단, 이 12개 테스트 케이스는 파이프라인 통합 점검용 프로브이며 공개 IR 벤치마크 점수를 보증하는 것은 아니다).

    반면 추론 지연시간에서는 NPU 모델의 직렬 연산 구조로 인한 뚜렷한 한계가 확인되었다.

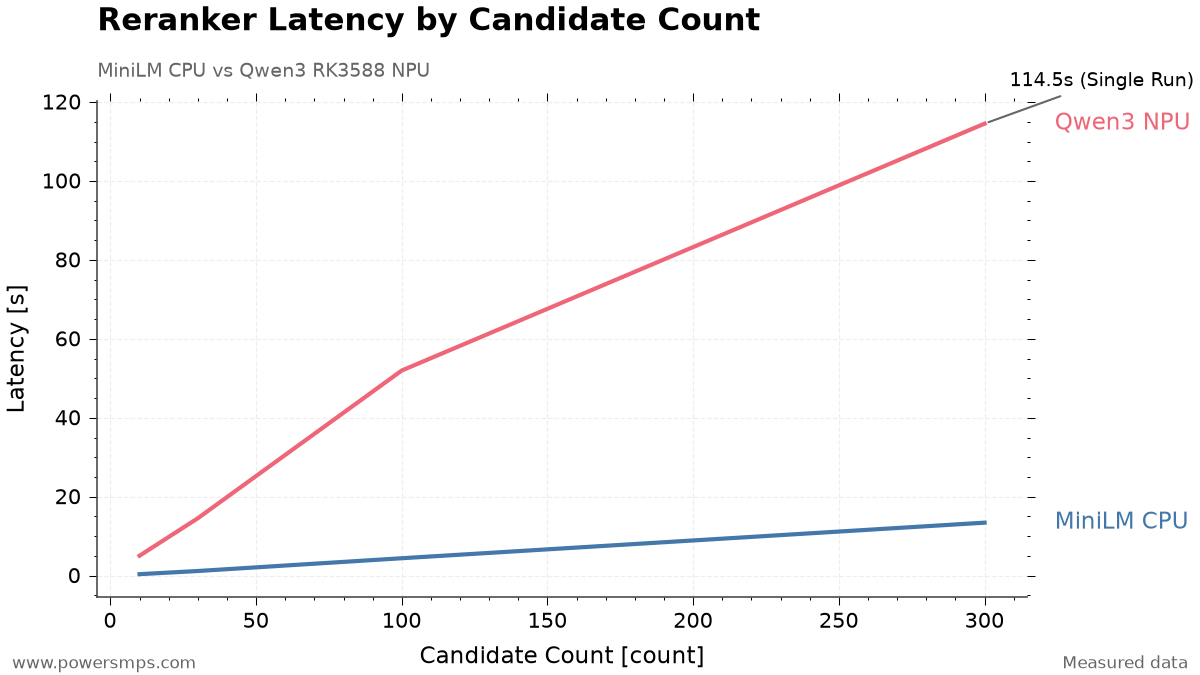
    후보 문서 수 MiniLM CPU (배치 크기 32) Qwen3 RK3588 NPU (단일 직렬 추론)
    10개 0.372초 (3회 중앙값) 5.047초 (3회 중앙값)
    30개 1.175초 (3회 중앙값) 14.544초 (3회 중앙값)
    100개 4.411초 (1회 관측치) 51.980초 (1회 관측치)
    300개 13.423초 (1회 관측치) 114.537초 (1회 관측치)
    Comparison of execution latency across candidate counts between MiniLM CPU (batch size 32) and Qwen3-Reranker-0.6B RK3588 NPU (serial execution). Data for 10 and 30 candidates represent medians of three runs; 100 and 300 candidates are single shared-host observations.
    Comparison of execution latency across candidate counts between MiniLM CPU (batch size 32) and Qwen3-Reranker-0.6B RK3588 NPU (serial execution). Data for 10 and 30 candidates represent medians of three runs; 100 and 300 candidates are single shared-host observations.

    후보 수별 시험은 공유 호스트에서 48개의 짧은 문서를 반복해 구성했다. Qwen의 전체 프롬프트 입력은 평균 약 108토큰이었다. 각 구현의 프롬프트와 토크나이저를 사용했으며, MiniLM은 배치 32로 처리하고 Qwen은 후보를 직렬로 처리했다. 표의 결과는 이 두 구현을 시험한 관측값이다.


    5. NPU 추론이 느려도 로컬 리랭커를 유지하는 실사용 운영 전략

    100개 후보 처리에 52초가 소요되는 지연시간은 실시간 대화형 서비스 관점에서는 매우 긴 대기시간이다. 그럼에도 불구하고 이 구성을 프로덕션에서 유지하고 있는 배경에는 운영자의 실제 워크플로우 특성과 구체적인 최적화 설정이 있다.

    실사용에서 속도 저하가 체감되지 않아 품질이 만족스러운 Qwen을 계속 쓰고 있다. 이는 현재 내 사용 환경에서의 평가다. 앞의 지연시간 측정값이 짧다는 의미로 일반화할 수는 없다.

    시스템 안정성을 유지하기 위해 두 가지 핵심 운영 정책을 적용했다.

    1) 사전 후보군 상한 50개 제한 정책

    초기 설정에서는 최대 300개의 후보 문서를 리랭커로 전달했다. 실제 메모리 회상 시험에서 244개의 후보 문서가 전달되었을 때, 리랭킹에만 181.868초가 소요되어 전체 회상 시간이 183.612초에 달했다.

    이에 Hindsight 설정에 HINDSIGHT_API_RERANKER_MAX_CANDIDATES=50을 적용하여 상호 순위 결합(RRF) 단계에서 상위 50개 후보만 리랭커로 전달하도록 제한했다. 동일 쿼리로 다시 측정한 결과, 리랭킹 처리시간은 104.259초로 42.67% 단축되었고, 전체 메모리 회상 소요시간은 105.791초로 42.38% 단축되었다. 서로 다른 입력과 측정 조건에서 나온 결과이므로 앞의 짧은 문서 시험과 지연시간을 직접 비교할 수는 없다.

    동일 쿼리 단일 실행 비교 이전 설정 (최대 300개 허용, 실 244개 처리) 상한 설정 (사전 상한 50개 적용, 실 50개 처리)
    평가된 후보 문서 수 244개 50개
    리랭킹 처리시간 181.868초 104.259초
    전체 메모리 회상 소요시간 183.612초 105.791초
    최종 반환된 메모리 수 48개 44개
    원본 출처 메모리 순위 1위 1위

    후보 수가 244개에서 50개로 약 5분의 1로 줄었음에도 소요시간이 비례적으로 줄어들지 않은 것은, 프롬프트 캐시 재사용률과 단일보드 공유 호스트의 백그라운드 자원 경합 등 복합적인 요인이 작용한 것으로 추정되며, 후보 수에 따른 선형적 지연시간 확장을 성능 보증으로 간주해서는 안 된다. 후보군을 50개로 캡핑하는 것은 지연시간을 낮추는 대신 잠재적으로 관련 있는 메모리가 리랭킹 대상에서 사전 제외될 수 있는 상충관계를 수반한다.

    2) 게이트웨이 직렬 큐잉과 다단계 타임아웃

    로컬 워커가 한 번에 하나의 요청을 처리하도록 Bifrost의 리랭커 동시성을 1, 채널 버퍼를 10으로 설정했다. 현재 전역 정책에서 버퍼가 가득 차면 추가 요청도 기다릴 수 있으므로, 버퍼 10은 전체 대기 요청의 절대 상한을 뜻하지 않는다.

    실제 합성 부하 시험(16개 문서 요청 1건 및 2개 문서 요청 10건 연속 유입)을 수행한 결과, 11건의 요청 모두 33.2~35.1초 범위 내에서 HTTP 200으로 정상 처리되었으며, NPU 워커 프로세스가 재시작 없이 안정적으로 재사용되었다.

    또한 예기치 않은 NPU 정체를 방지하기 위해 다단계 타임아웃 마진을 구성했다.

    • Hindsight 리랭커 타임아웃: 1800초 (30분)
    • Bifrost 업스트림 소켓 타임아웃: 780초
    • 로컬 C++ 네이티브 추론 타임아웃: 600초
    • 네이티브 큐 대기 타임아웃: 120초

    이러한 타임아웃 수치는 시스템의 정상 응답 속도가 아니라, 요청이 대기열에 머물거나 비정상적으로 지연될 때 안전하게 프로세스를 재기동하기 위한 안전 마진이다.


    6. 운영 한계와 의사결정 기준: 단일보드 LLM 시스템의 워크로드 분배

    로컬 리랭커를 유지할지는 API 비용과 결과 품질, 대기시간을 함께 보고 판단해야 한다. 현재 구성을 유지하는 이유와 그 한계는 다음과 같다.

    KURE의 고정 256토큰 FP16 RKNN 모델도 시험했다. 동일한 50개 입력에서 HTTP 리랭크 응답시간은 KURE 10.647초, Qwen 27.798초였다. 다만 KURE에서는 2개 입력의 문서가 잘렸고, 별도 실제 회상 시험에서는 최종 순위도 달라졌다. 이 표본으로 두 모델의 전반적인 품질 우열을 단정할 수는 없다. 현재는 Qwen을 유지하고 있다.

    둘째, 벤치마크 표본의 한계다. 본 운영에서 확인된 정답 1위 11/12(Top-1 적중률) 및 MRR 0.9375의 순위 성능은 서비스 배포를 위한 최소한의 파이프라인 점검용 프로브 결과일 뿐이며, 대규모 한국어 정보 검색(IR) 데이터셋에서의 일반적인 검색 성능을 대변하지 않는다.

    이번 운영에서의 선택 기준은 다음과 같다.

    1. 임베딩: 현재 사용량에서는 API 비용이 낮아 로컬 운영의 필요성을 느끼지 못했다.
    2. 리랭커: API 비용 부담으로 로컬 Qwen을 선택했다. 품질에 만족하고 실사용에서 속도 저하가 체감되지 않아 유지하고 있다.

    현재 사용량에서는 임베딩을 API로 유지할 이유가 충분했고, 리랭커는 비용과 품질을 보고 로컬로 유지할 이유가 있었다. 사용량이나 응답시간 요구가 달라지면 이 선택도 다시 검토할 수 있다.
  • Anima RKNN 추론 최적화: Spectrum으로 생성 시간 41% 단축

    Anima RKNN 추론 최적화: Spectrum으로 생성 시간 41% 단축

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.

    1. 이미지 생성 시간을 줄이려면

    단일 보드 컴퓨터(Single Board Computer, SBC) 환경에서 대규모 확산 변환기(Diffusion Transformer, DiT)를 온디바이스로 구동할 때는 메모리 제약과 연산 시간이 주요 병목이다. Radxa 알리익스프레스 공식 스토어에서 직접 구매한 Radxa ROCK 5C 8GB 보드를 사용해 2026년 8월 환경 기준으로 Anima DiT 추론 최적화 실험을 진행했다.

    512×512 이미지의 20스텝 디노이징에는 2,408.54초가 걸렸다. VAE로 이미지를 복원하는 시간까지 합하면 한 장을 만드는 데 30분을 넘겼다. 계산량을 줄이면서 결과의 화질을 유지할 방법이 필요했다.

    1편에서 실행한 FP16 RKNN 구성에 Spectrum을 적용했다. Euler 스케줄러는 유지하면서 일부 스텝의 모델 계산을 이전 결과에 기반한 예측으로 대체하고, 속도와 화질을 비교했다.

    2. 비교에 사용한 하드웨어와 모델 구성

    실험 하드웨어는 Rockchip RK3588S2 SoC와 8GB 시스템 메모리를 탑재한 Radxa ROCK 5C 단일 보드 컴퓨터다.

    RKNN 런타임 타깃은 rk3588이다. 실험 장비는 ROCK 5C 8GB이며, 같은 상품 페이지의 ROCK 5C Lite와 구분해야 한다.

    Anima의 28개 DiT 블록을 self-attention·cross-attention·FFN으로 나눈 84개 FP16 RKNN 모델을 사용했다. 기본 변환 구조는 1편에서 다룬 구성과 같다.

    NPU는 주요 행렬·어텐션 연산을 처리한다. CPU는 AdaLN과 FP32 잔차 누적, Euler 스케줄러, 텍스트 인코딩과 VAE 디코딩을 담당한다. Spectrum을 추가한 뒤에도 이 역할 분담은 유지했다.

    3. Spectrum은 어떤 계산을 생략하는가

    Spectrum은 Euler를 대체하는 샘플러가 아니다. 이전 계산 결과로 현재 스텝의 denoised 상태를 예측해 모델 재계산을 줄이는 캐싱 기법이다. stable-diffusion.cpp의 Spectrum 구현을 NumPy로 옮겨 Euler 루프에 적용했다.

    Spectrum의 핵심 원리는 확산 과정에서 스텝 간 잠재 변수의 궤적이 급격하게 변화하지 않는 특성을 활용하여, 이전 히스토리 버퍼로부터 denoised 상태인 \(x_0\) 추정치를 예측(forecasting)하는 방식이다.

    각 스텝에서 직접 계산과 예측 중 하나를 선택한다. 두 경로 모두 같은 Euler 스케줄러에 결과를 전달한다.

    • 직접 계산하는 스텝에서는 조건부·무조건부 출력을 CFG로 합성하고, x₀ = xₜ − σ × prediction으로 denoised 상태를 구해 이력에 저장한다.
    • 예측 스텝에서는 이전 이력으로 현재의 x₀를 추정해 NPU 모델 계산을 생략한다.
    • 추정한 x₀는 prediction = (xₜ − x₀) / σ로 흐름 예측값에 되돌린다. 두 경로 모두 같은 Euler 적분기로 다음 상태를 갱신한다.

    이 구조 덕분에 스케줄러 자체는 FlowMatch Euler 방식을 유지하면서도 NPU에 가해지는 텐서 연산 횟수를 줄일 수 있다.

    4. 20스텝 중 11회 계산, 9회 예측

    20스텝 실행에서 직접 계산한 스텝과 예측으로 대체한 스텝은 다음과 같다.

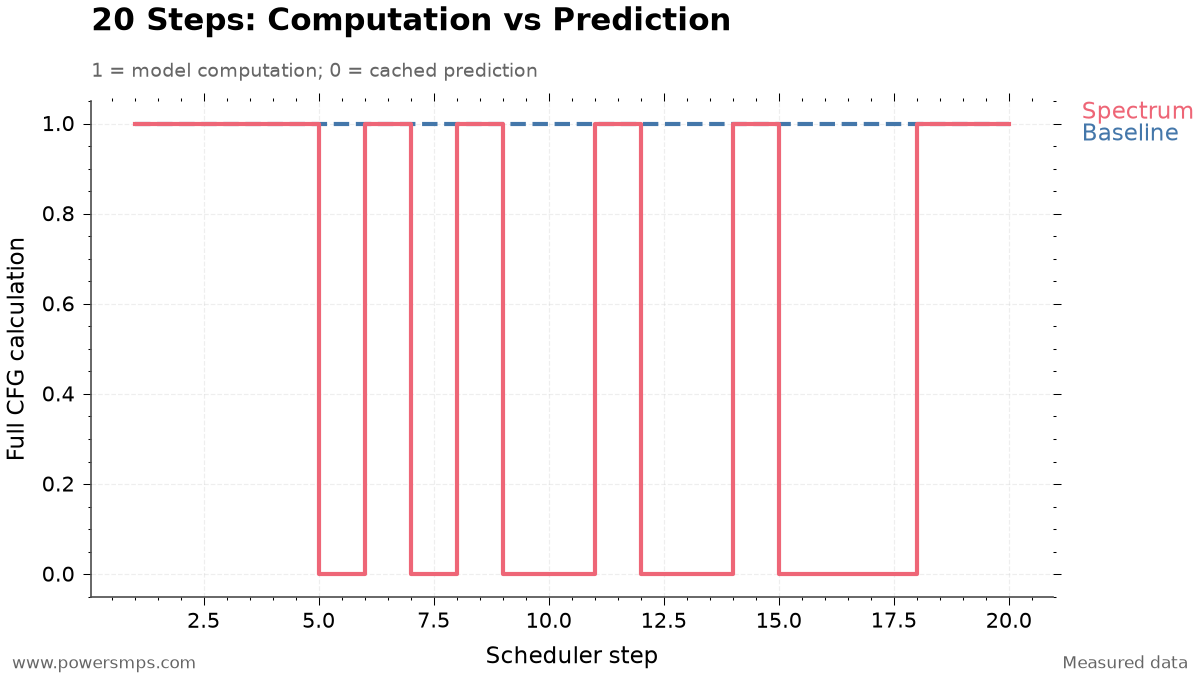
    • 실제 모델 계산 스텝 (11회): Step 1, 2, 3, 4, 6, 8, 11, 14, 18, 19, 20
    • 상태 예측 건너뛰기 스텝 (9회): Step 5, 7, 9, 10, 12, 13, 15, 16, 17

    처음 4개 스텝은 모두 계산해 예측에 필요한 이력을 쌓았다. 중간 구간에서는 9개 스텝을 예측으로 대체했고, 마지막 18~20스텝은 다시 직접 계산했다.

    20-Step Sampling Policy: Baseline vs Spectrum Forecasting
    20-Step Sampling Policy: Baseline vs Spectrum Forecasting

    여기서 계산 스텝 11회는 NPU 실행 11회를 뜻하지 않는다. CFG 한 번에는 조건부·무조건부 입력에 대한 DiT 평가가 각각 필요하다.

    각 transformer 평가는 28개 블록에 배치된 84개의 RKNN 서브그래프를 순회하므로, 1회의 CFG 평가는 168회(84 × 2)의 서브그래프 NPU 실행으로 구성된다. 따라서 Spectrum 파이프라인의 11회 모델 계산은 다음과 같은 실제 하드웨어 순회량을 가진다.

    • 전체 모델 순회(Transformer Pass): 11회 × 2 = 22회
    • 서브그래프 NPU 실행 횟수: 11회 × 2 × 84개 = 1,848회

    반면 기준선 파이프라인은 20스텝 동안 40회의 transformer pass와 3,360회의 서브그래프 NPU 실행을 거친다. 즉, Spectrum은 정확히 18회의 모델 순회와 1,512회의 서브그래프 실행을 건너뜀으로써 하드웨어 부하를 절감했다.

    5. 실측 결과: 전체 생성 시간 41.02% 단축

    기준선과 Spectrum은 같은 ROCK 5C 8GB에서 비교했다. 해상도 512×512, 20스텝, CFG 4.0, 시드 20260812를 동일하게 고정했다.

    평가 항목 기존 비캐시 FP16 RKNN + sd-cpp VAE Spectrum 가속 시험 파이프라인 변화폭 및 배율
    20-step Denoise 시간 2,408.54초 1,356.58초 1,051.96초 단축 (43.68% 감소, 1.775배 가속)
    sd-cpp tiled CPU VAE 디코딩 155.04초 155.46초 +0.42초 (동일 범주의 실행 변동)
    합계 소요 시간 (프롬프트 인코딩 제외) 2,563.58초 1,512.04초 1,051.54초 단축 (41.02% 감소, 1.695배 가속)

    실측 수치가 보여주는 병목과 최적화의 특성은 다음과 같다.

    1. Denoise 연산 가속의 집중: 순수 20스텝 denoise 소요 시간은 기준선 2,408.54초에서 Spectrum 시험 시 1,356.58초로 1,051.96초 감소했다. 이는 43.68%의 시간 단축이자 1.775배의 속도 향상이다. 20스텝 중 9스텝의 연산(45%)을 건너뛴 비율과 거의 일치하는 선형적 가속 효율을 달성했다.
    2. VAE 디코딩의 독립성: ggml 백엔드 기반 ARM NEON/OpenMP로 구동되는 sd-cpp 경량 타일드 CPU VAE 디코더는 기준선 155.04초, Spectrum 파이프라인 155.46초로 0.42초의 차이를 보였다. 이번 비교에서 VAE 시간은 거의 같았으며, 시간 절감은 주로 denoise 구간에서 나타났다.
    3. 전체 파이프라인 가속: 프롬프트 인코딩을 제외한 전체 파이프라인 합계 소요 시간은 기준선 2,563.58초(약 42분 43초)에서 1,512.04초(약 25분 12초)로 1,051.54초 단축되었다. 전체 생성 파이프라인은 41.02% 단축되어 1.695배의 가속을 달성하였으며, 30분 이내 생성을 달성하겠다는 프로젝트 목표를 충족했다.

    6. 빨라진 결과의 화질은 어떤가

    스텝 예측을 수행하는 캐시 알고리즘은 누적 오차로 인해 잠재 공간이 발산하거나 비정상적인 수치(NaN, Inf)를 생성할 위험이 있다. 따라서 파이프라인 완료 직후 생성된 텐서에 대한 수치 검증과 이미지 레벨의 품질 검증을 단계별로 수행했다.

    20스텝을 완료한 최종 잠재 변수에서 NaN과 Inf는 발생하지 않았다. 수치가 발산하지 않는지는 최종 이미지의 화질과 별도로 확인했다.

    512×512 생성 이미지는 이 실험의 육안 화질 기준을 충족했다. 따라서 이번 조건에서는 생성 시간을 줄이면서 허용 가능한 결과를 얻었다.

    본 사용자 육안 판정 결과는 특정 조건(512×512 해상도, 20 스텝, Guidance Scale 4.0, Seed 20260812)의 단일 실험 1건에 한정된 검증이다. Spectrum의 \(x_0\) 예측은 수학적으로 완전한 무손실(lossless) 계산이 아니며, 근사 예측에 따른 미세한 잠재공간 오차가 존재한다. 따라서 이 결과가 기준선과의 완벽한 수치적 일치를 의미하거나, 임의의 다른 프롬프트와 시드에서도 품질 저하가 전혀 발생하지 않는다는 무손실 품질을 보증하는 것은 아니다.

    7. 같은 가중치로 기준선과 비교하기

    Spectrum은 어느 스텝을 직접 계산할지 바꾸며, 모델 가중치를 다시 양자화하거나 변환하는 방식이 아니다.

    같은 84개 FP16 RKNN 모델을 사용하므로, 예측 캐싱을 끄면 모든 스텝을 계산하는 기준선으로 돌아갈 수 있다.

    • 같은 프롬프트·시드·스텝 수로 캐싱을 켠 결과와 끈 결과를 비교한다.
    • 수치 안정성뿐 아니라 최종 생성 이미지의 화질도 함께 확인한다.
    • 새 조건에서 품질이 기준에 못 미치면 예측을 끄고 전체 스텝을 계산한다.

    이번 조건에서는 총 생성 시간이 41.02% 줄었다. 다른 프롬프트와 시드에 적용할 때도 기준선과 화질을 비교한 뒤 사용할 필요가 있다. 3편에서는 연산 속도를 줄여도 화질이나 메모리 때문에 채택하지 못한 다른 최적화를 살펴본다.

  • Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험

    Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.


    1. 더 빠른 추론을 위한 두 가지 시도

    ROCK 5C 8GB에서 Anima 추론을 실행한 뒤, FFN 양자화와 모델 상주라는 두 가지 최적화를 비교했다. 보드는 RK3588S2를 탑재했으며, 실험은 2026년 8월 RKNN-Toolkit2 2.3.2 환경에서 진행했다.

    1편과 같은 84개 FP16 RKNN 분할 구성을 기준으로 삼았다. NPU가 attention과 FFN을 처리하고 CPU가 AdaLN과 FP32 잔차 누적을 담당한다. 이번 질문은 계산을 더 빠르게 하거나, 반복되는 모델 준비 시간을 줄일 수 있는가다.

    512×512 고정 해상도에서 84개 서브그래프를 순차 실행하는 구조는 매 스텝마다 모델을 로드, 초기화, 해제하는 고유한 오버헤드를 발생시킨다. 이에 따라 시스템 최적화를 위한 두 가지 핵심 가설을 설정했다. 1. 연산 가속 가설: 연산 부하가 큰 FFN 레이어에 W8A8 정수 양자화를 적용해 NPU 실행 시간을 단축한다. 2. 라이프사이클 단축 가설: 84개 RKNN 모델의 런타임 컨텍스트를 메모리에 상주(Resident Context)시켜 매 스텝 반복되는 로드 및 초기화 시간을 제거한다.

    이 두 가지 접근법을 ROCK 5C 8GB 환경에서 실측 검증한 결과, 화질 저하와 물리 메모리 한계라는 구체적인 병목에 직면했다.


    2. FFN 양자화로 디노이징 시간 18.48% 단축

    DiT의 전체 84개 RKNN 서브그래프 중 연산량이 집중된 28개 블록의 FFN(Feed-Forward Network) 영역에 정수 양자화를 적용했다. FFN 내부의 Linear(2048→8192) 및 Linear(8192→2048) 레이어의 weight와 activation을 INT8로 양자화(W8A8)하고, 비선형 활성화 함수인 GELU와 분기 출력부는 FP16으로 유지하는 하이브리드 빌드 방식을 채택했다. self-attention 및 cross-attention 코어는 기존 FP16 구성을 유지했으며, 호스트 측의 residual stream 역시 FP32 정밀도를 보존했다.

    양자화 보정에는 기존 FP16 디노이징 과정에서 수집한 활성화 텐서를 사용했다. 높은 시그마·낮은 시그마와 조건부·무조건부 CFG 분기를 조합해 블록당 4개, 총 112개를 수집했다. 28개 FFN 블록이 모두 변환되었다.

    동일한 초기 잠재 변수(seed: 20260812), 프롬프트 컨텍스트, CFG 4.0 스케일, 20스텝 조건에서 성능을 비교 측정한 결과는 다음과 같다.

    항목 기존 FP16 FFN Linear W8A8 변화량
    20스텝 디노이즈 시간 2,408.54초 1,963.45초 445.09초 단축 (18.48% 개선)
    스텝당 평균 소요 시간 120.40초 98.15초 22.25초 단축
    스텝당 평균 FFN 코어 실행 44.76초 23.57초 1.90배 가속
    스텝당 평균 Self 코어 실행 24.00초 25.74초 실행 편차 수준
    스텝당 평균 Cross 코어 실행 7.45초 7.69초 실행 편차 수준

    전체 디노이징은 1.227배, 양자화를 적용한 FFN 구간은 1.90배 빨라졌다. 실행 중 NaN과 Inf는 발생하지 않았다.


    3. 실행은 빨라졌지만 화질은 기준 미달

    디노이징 시간은 18.48% 줄었지만, VAE 디코딩을 거친 512×512 이미지는 육안 화질 기준을 충족하지 못했다.

    수치가 발산하지 않는 것과 이미지의 품질이 충분한 것은 별개였다. 이번 W8A8 구성은 수치 안정성은 유지했지만 화질 기준을 통과하지 못했다.

    따라서 FFN 양자화는 채택하지 않고 FP16 구성으로 돌아갔다. 생성 모델의 최적화는 실행 시간뿐 아니라 최종 이미지 품질을 함께 비교해야 한다.


    4. 모델을 메모리에 두면 줄일 수 있는 시간

    화질 저하 없이 추론 시간을 단축하기 위해 다음으로 검토한 가설은 84개 서브그래프의 로드 및 초기화 오버헤드를 제거하는 런타임 모델 상주(Resident Context) 방식이다.

    분할 구성은 각 모델을 로드하고 런타임을 초기화한 뒤 추론을 수행하고 해제한다. 84개 모델을 한 번 순회하는 이 준비·정리 비용을 3회 측정한 평균은 다음과 같다.

    라이프사이클 단계 84개 모델 1회 순회 소요 시간 (평균) 비고
    load_rknn 13.96초 호스트 메모리로 모델 가중치 로드
    init_runtime 12.90초 NPU 드라이버 컨텍스트 생성 및 DMA 매핑
    release 4.84초 NPU 런타임 및 디바이스 매핑 해제
    순수 단계 합계 31.71초 루프 오버헤드 포함 wall time: 33.84초

    분기별 모델당 평균 라이프사이클 시간은 self-attention 0.423초, cross-attention 0.200초, FFN 0.510초로 나타났다.

    28스텝 Spectrum 샘플러 운용 조건에서는 전체 28스텝 중 15스텝이 예측 연산으로 대체되고 실제 NPU 연산은 13회의 compute 스텝에 걸쳐 발생한다. 따라서 이미지 1장을 생성할 때 수행되는 총 라이프사이클 횟수는 84 models × 13 steps = 1,092회이며, 순수 라이프사이클 누적 시간은 약 412.2초에 달한다.

    만약 84개 컨텍스트를 메모리에 상시 상주시키는 것이 가능하다면, 최초 1회의 준비(load/init) 및 최종 1회의 해제(release)에 소요되는 31.71초를 제외한 나머지 12회분의 라이프사이클 시간을 이론적으로 제거할 수 있다.

    \[\Delta T_{\text{theoretical}} = 31.708\,\text{s} \times (13 – 1) = 380.50\,\text{s} \approx 6.34\,\text{분}\]

    이 계산에 따르면 평균 28.56분(1,713.78초)이 소요되던 전체 생성 시간을 22.22분(1,333.28초)까지 단축할 수 있다는 계산이 성립한다. 그러나 이 수치는 84개 컨텍스트 상주가 물리적으로 가능하다는 전제하에 도출된 이론적 상한일 뿐이며, 실제 상주 디노이즈 파이프라인에서 측정되거나 달성된 성능이 아니다.


    5. 18개 컨텍스트에서 드러난 메모리 한계

    모델을 하나씩 메모리에 올리면서 실제 메모리 점유와 스왑 증가량을 측정했다. 전체 상주를 실행하기 전에 8GB 환경에서 감당할 수 있는지 확인하기 위한 실험이다.

    벤치마크의 안전 중단 조건은 여유 메모리(MemAvailable) 1.5 GiB 미만 또는 시스템 스왑 16 MiB 초과로 설정했다. 1개부터 순차적으로 컨텍스트를 로드한 결과는 다음과 같다.

    상주 컨텍스트 수 프로세스 절대 PSS 기준선 대비 추가 PSS MemAvailable 변화 시스템 스왑 증가량
    1개 365.4 MiB 154.9 MiB -151.8 MiB 0 MiB
    4개 765.6 MiB 555.1 MiB -558.5 MiB 0 MiB
    8개 1,262.6 MiB 1,052.1 MiB -1,000.3 MiB 1.3 MiB
    12개 1,823.3 MiB 1,612.8 MiB -1,567.6 MiB 5.0 MiB
    16개 2,354.9 MiB 2,144.4 MiB -2,104.2 MiB 9.0 MiB
    18개 2,631.4 MiB 2,420.9 MiB -2,372.5 MiB 21.4 MiB (중단)

    18번째 컨텍스트를 로드하는 시점에서 프로세스의 절대 PSS는 약 2.57 GiB(2,631.4 MiB)에 도달했으며, 기준선 대비 추가 PSS는 약 2.36 GiB(2,420.9 MiB)를 기록했다. 시스템 스왑이 기준선 대비 21.4 MiB 증가하여 안전 기준(16 MiB 초과)에 의해 실험이 조기 중단되었다. 로드된 18개 컨텍스트는 즉각 안전하게 해제(release wall time: 1.05초)되었으며 디바이스 매핑이 회수되었다.

    메모리 증가는 호스트 텐서뿐 아니라 NPU 드라이버의 디바이스 매핑에서도 나타났다. 16개 컨텍스트를 유지했을 때 디바이스 매핑이 약 1.357 GiB였고, 30초 유지 중 시스템 스왑은 19.5 MiB 증가했다.

    16~18개 컨텍스트의 실측 메모리 증가율을 바탕으로 84개 전체 모델 상주 시의 소요량을 선형 외삽하면 다음과 같은 계산이 나온다. – 예상 디바이스 매핑 메모리: 약 7.1 GiB – 예상 프로세스 총 추가 PSS: 약 11.3 GiB

    ROCK 5C 보드의 전체 물리 RAM은 7.75 GiB다. OS 기본 점유 메모리, CPU 호스트 측 가중치 및 연산 버퍼(약 0.8~1.0 GiB), 프롬프트 인코더와 VAE 디코더의 상주 공간을 감안하기 이전에도 추가 PSS 11.3 GiB의 메모리 요구량은 하드웨어 한계를 초과한다. 따라서 84개 서브그래프의 동시 상주는 메모리 게이트를 통과할 수 없다.


    6. 작은 LRU 캐시로 해결할 수 있을까

    전체 84개 상주가 불가능하다면, 4~16개 정도의 제한된 컨텍스트 풀을 LRU(Least Recently Used) 방식으로 운용하거나 일부 모델만 고정 상주시키는 대안을 검토할 수 있다.

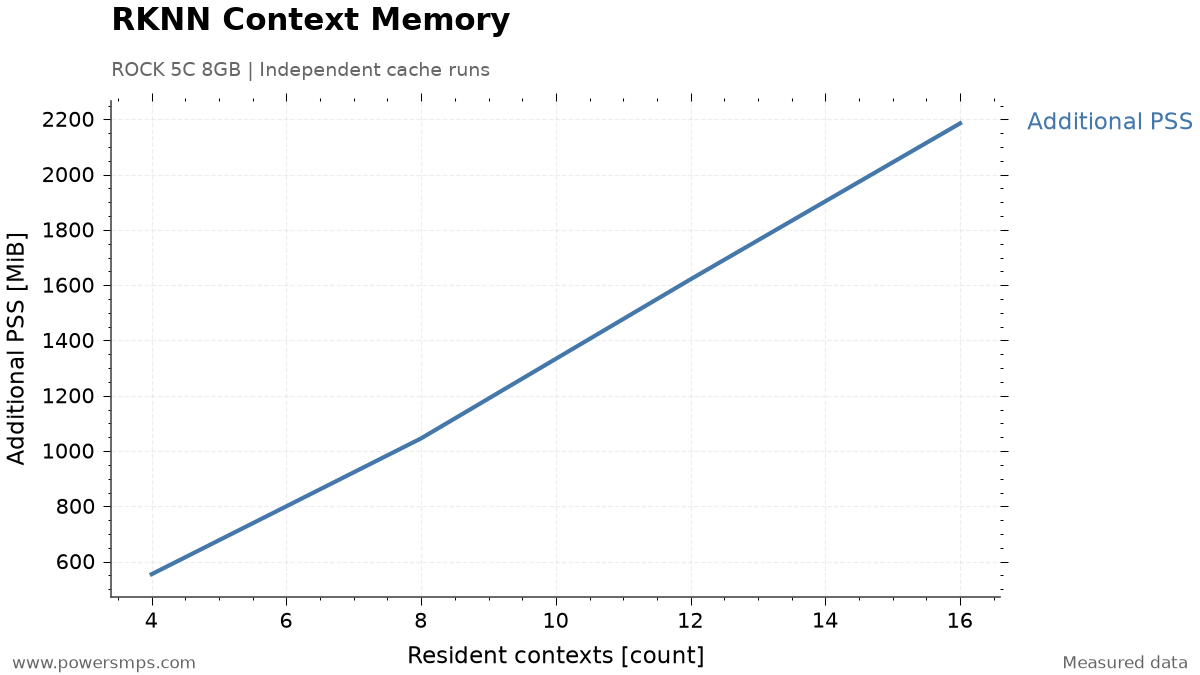
    새로운 독립 프로세스에서 4, 8, 12, 16개 컨텍스트 풀을 할당하여 실측한 추가 PSS 메모리는 각각 554.8 MiB(약 0.54 GiB), 1,046.1 MiB(약 1.02 GiB), 1,621.5 MiB(약 1.58 GiB), 2,185.4 MiB(약 2.13 GiB)였다.

    Radxa ROCK 5C 8GB 환경에서 독립 프로세스 실행 시 RKNN 상주 컨텍스트 수(4, 8, 12, 16개)에 따른 추가 PSS(MiB) 실측 증가 추이.
    Radxa ROCK 5C 8GB 환경에서 독립 프로세스 실행 시 RKNN 상주 컨텍스트 수(4, 8, 12, 16개)에 따른 추가 PSS(MiB) 실측 증가 추이.

    컨텍스트 증가에 따라 추가 PSS는 대체로 증가하는 경향을 나타내지만 엄밀한 완전 선형 관계는 아니다. 또한 이러한 제한 캐시 전략은 DiT의 순방향 연산 구조로 인해 실효성을 상실한다.

    스텝 n의 순차 호출열 (총 84개 모델)
    [Model 00 (self) → Model 01 (cross) → Model 02 (FFN) → ... → Model 83 (FFN)]
      ↓ 잔차 연결 누적 및 스케줄러 잠재 변수 갱신
    스텝 n+1의 순차 호출열 (총 84개 모델 동일 순회)
    [Model 00 (self) → Model 01 (cross) → Model 02 (FFN) → ... → Model 83 (FFN)]
    

    DiT 블록의 각 분기 출력은 즉시 호스트의 FP32 residual stream에 합산되어 다음 분기 및 블록의 입력으로 주입된다. 또한 84개 분기 연산이 모두 완료된 후에야 샘플러가 디노이즈 잠재 변수를 갱신하고 다음 디퓨전 스텝으로 진행할 수 있다. 즉, 모델 간의 순차적 의존성 때문에 호출 루프의 순서를 바꾸는 루프 인터체인지(Loop Interchange)가 불가능하다.

    구조상 84개 모델은 고정된 순서로 1스텝당 1회씩 순환 참조된다. 같은 모델이 다시 호출되기 전에는 다른 83개 모델을 거친다. 따라서 캐시 용량이 84 미만인 일반 LRU 캐시(예: capacity 4, 8, 16, 28, 56 등)를 적용할 경우, 캐시에 적재된 모델은 재사용되기 직전에 반드시 캐시 밖으로 축출된다. – LRU 시뮬레이션 결과: 총 1,092회 호출 중 0 hit / 1,092 miss (캐시 적중률 0%)

    일부 모델(예: 0~15번 모델)을 축출 없이 메모리에 고정 적재하는 방식(Static Pinning)을 적용하더라도, 16개 모델 기준 절감 가능한 시간은 compute 스텝당 16개분의 라이프사이클에 불과하여 이미지 1장당 이론상 최대 약 72.4초 절감에 그치며 이는 실제 달성된 측정값이 아니다. 반면 이를 위해 지불해야 하는 비용은 2.13 GiB(2,185.4 MiB)의 추가 PSS 점유와 장기 유지 시 발생하는 스왑이다. 72.4초의 제한된 이론적 절감을 위해 시스템 안정성을 희생하고 스왑 지터를 유발하는 것은 엔지니어링 관점에서 불합리한 선택이다.


    7. 8GB에서 유지한 구성

    W8A8 FFN 정수 양자화와 모델 상주 컨텍스트 캐시 실험을 통해 도출된 핵심 병목과 검증 결과는 다음과 같다.

    • FFN W8A8 양자화: 계산은 빨라졌지만 육안 화질 기준에 못 미쳤다.
    • 전체 모델 상주: 18개 컨텍스트에서 스왑이 늘었고, 84개 상주의 추가 PSS는 약 11.3 GiB로 외삽됐다.
    • 제한 캐시: 순환 호출에서는 재사용 전에 축출되어 LRU 적중을 얻지 못했다.

    ROCK 5C 8GB에서는 FP16 모델을 유지하고, 필요한 모델만 준비해 실행한 뒤 해제하는 방식을 선택했다. 이번 비교에서는 상주 시간을 늘리는 이득보다 메모리 부담이 컸다.

    이 판단은 이번 8GB 보드와 분할 구성에 대한 결과다. 메모리 용량이나 모델 분할 방식이 달라지면 상주의 손익도 다시 비교해야 한다.

    모델을 메모리에 쌓아두는 대신, 84개로 나뉜 그래프를 더 적은 수로 합칠 수는 없을까? 4편에서는 컴파일러 버전을 바꾸어 그래프 융합을 시도하고 속도·메모리 비용을 비교한다.

  • RKNN Toolkit 2.3.2와 2.3.0 비교: AdaLN 컴파일 충돌과 fusion 실험

    RKNN Toolkit 2.3.2와 2.3.0 비교: AdaLN 컴파일 충돌과 fusion 실험

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.


    1. 분할한 DiT 블록을 다시 합칠 수 있을까

    임베디드 NPU 환경에서 생성형 확산 모델(Diffusion Transformer)을 구동할 때, 런타임 메모리 제한과 연산자 지원 여부는 아키텍처 설계를 직접 결정짓는 핵심 요인이다. 이번 심화 실험은 2026년 8월 20일 Radxa ROCK 5C 8GB 단일 보드 컴퓨터 환경에서 진행되었다.

    실험에는 직접 구매한 ROCK 5C 8GB 보드를 사용했다.

    실험 보드는 RK3588S2 기반 ROCK 5C이며, RKNN 타깃은 rk3588이다. 같은 판매 페이지의 ROCK 5C Lite와 구분해야 한다.

    1편의 Anima 구성은 28개 DiT 블록을 각각 attention·cross-attention·FFN으로 나눈 84개 FP16 RKNN 모델이다. AdaLN과 잔차 연결은 CPU에서 처리한다. 여기서는 블록당 3개 모델을 하나로 합칠 수 있는지 살펴봤다.

    기존 파이프라인에서는 AdaLN(Adaptive LayerNorm) 연산과 잔차 연결(Residual Addition)을 호스트 CPU 파이썬 런타임에서 처리해 왔다. 그러나 단일 DiT 블록 내에서 3개의 서브그래프를 매 스텝마다 각각 로드·실행·해제하고 중간 결과를 CPU 호스트로 왕복시키는 구조는 상당한 드라이버 오버헤드를 발생시킨다. 만약 블록 내의 Self-Attention, Cross-Attention, FFN 및 AdaLN을 단일 RKNN 그래프로 융합(fused 1-model)할 수 있다면, 블록당 라이프사이클 호출 횟수를 3회에서 1회로 줄이고 호스트 텐서 전송 비용을 절감할 수 있을 것으로 기대되었다.

    그러나 당시 기본 컴파일러로 사용하던 RKNN Toolkit 2.3.2 환경에서 AdaLN 연산자가 포함된 그래프를 컴파일할 때 치명적인 컴파일러 세그멘테이션 폴트(SIGSEGV, exit code 139)가 발생했다. 이 크래시가 Anima DiT 구조 자체의 근본적인 하드웨어 비지원인지, 컴파일러 버그인지 검증하는 작업이 선행되어야 했다.


    2. 같은 AdaLN 그래프를 다른 툴킷으로 빌드하기

    컴파일러 충돌 문제를 분석하기 위해, 거대한 전체 DiT 블록 대신 충돌을 유발하는 AdaLN 연산자만 격리한 최소 재현용 ONNX 모델(Minimal AdaLN reproducer)을 추출하여 컴파일 실험을 수행했다.

    같은 AdaLN 재현 그래프를 RKNN Toolkit 2.3.2와 2.3.0으로 각각 빌드했다. 다른 조건은 유지하고 컴파일러 버전에 따른 결과를 비교했다.

    동일한 reproducer ONNX 모델, 동일한 타깃(rk3588), 동일한 단일 코어 최적화 옵션에서 측정된 빌드 결과는 다음과 같다.

    툴킷 버전AdaLN 그래프 빌드종료 코드
    2.3.2실패: SIGSEGV139
    2.3.0성공0

    2.3.2에서는 LayerNorm 관련 그래프 최적화 뒤 SIGSEGV로 빌드가 중단됐다. 2.3.0에서는 같은 그래프가 정상적으로 빌드됐다.

    동일한 입력 그래프와 타깃에서 버전에 따라 결과가 달라져, 이번 실패는 컴파일러 회귀 문제로 판단했다. 이전 버전인 2.3.0이 이번 그래프의 회피 경로가 되었으며, 새 버전으로 올려 해결한 사례는 아니다.


    3. 64px·512px 융합 모델 실행 확인

    Toolkit 2.3.0으로 첫 번째 DiT 블록의 융합 모델을 빌드했다. 64px 테스트 구성과 512px 실제 추론 구성을 나누어 확인했다.

    융합 블록 해상도RKNN 변환보드에서 실행
    64px성공초기화·추론 확인
    512px성공초기화·추론·해제 확인

    512px 모델 빌드는 스왑 없이 완료됐다. 일부 Transpose와 Erf 연산은 CPU로 배치되었으므로, 단일 RKNN 파일로 합쳤다고 해서 모든 연산이 NPU에서 실행되는 것은 아니다.

    더 중요한 검증 포인트는 타깃 보드 로컬 런타임과의 바이너리 호환성이었다. 컴파일러를 2.3.0으로 빌드했더라도 보드 OS의 RKNPU 커널 드라이버나 런타임 라이브러리를 강제로 교체해야 한다면 배포 복잡도가 급격히 상승한다.

    빌드한 모델은 런타임 API 2.3.0·드라이버 0.9.8 환경에서 실행했다. 커널이나 드라이버를 교체하지 않고 로드·초기화·추론·해제를 확인했으며, 조건부·무조건부 추론을 3라운드 반복했다.

    이번 단일 블록 검증에서는 컴파일러 환경만 바꾸어도 기존 보드 런타임에서 실행할 수 있었다.


    4. 단일 블록 출력의 수치 차이

    융합 모델의 하드웨어 실행이 확인된 후, NPU 융합 연산 결과가 원본 부동소수점 기준 텐서와 수치적으로 일치하는지 단일 블록 수치 검증(Correctness Gate)을 수행했다. 기준 참조 텐서는 PyTorch FP16 원본 블록 연산 결과와 ONNX Runtime(ORT) 결과다.

    대상 아키텍처 기준 참조 텐서 (Reference) 코사인 유사도 (Cosine) 최대 절대 오차 (Max Abs) 평균 절대 오차 (Mean Abs) 평균 제곱 오차 (MSE) NaN/Inf 검출
    64px Fused PyTorch 0.99998315 0.28125 0.0018879 4.2748e-05 0 / 0
    64px Fused ONNX Runtime 0.99998608 0.28125 0.0018948 3.5387e-05 0 / 0
    512px Split (기존) PyTorch 0.99999881 0.14937 0.0002283 1.0841e-06 0 / 0
    512px Fused (후보) PyTorch 0.99997673 0.25000 0.0011279 2.1100e-05 0 / 0
    512px Fused (후보) ONNX Runtime 0.99997590 0.28906 0.0011662 2.1854e-05 0 / 0

    512px 융합 모델은 PyTorch 기준 출력과의 코사인 유사도 0.99997673, 최대 절대 오차 0.25000을 기록했고 NaN과 Inf는 발생하지 않았다.

    다만 융합 모델의 MSE는 2.1100e-05로, 기존 분할 방식의 1.0841e-06보다 약 19.5배 컸다. 단일 블록의 높은 코사인 유사도만으로는 전체 28개 블록과 여러 스텝을 거친 최종 이미지의 화질까지 확인할 수 없다.


    5. 호출은 줄었지만 속도 이득은 0.47%

    서브그래프 융합을 추진했던 가장 핵심적인 목적은 지연 시간 단축이었다. 호스트 파이썬에서 실행되던 AdaLN 및 잔차 연산을 컴파일된 그래프 내부로 옮기고 드라이버 컨텍스트 호출 횟수를 줄임으로써 속도 향상을 기대했다.

    ROCK 5C 보드에서 512px 단일 블록에 대해 CFG(Classifier-Free Guidance) 2회 연산 스트림을 3라운드 실행하고, 각 단계별 소요 시간의 평균치를 정밀 계측했다.

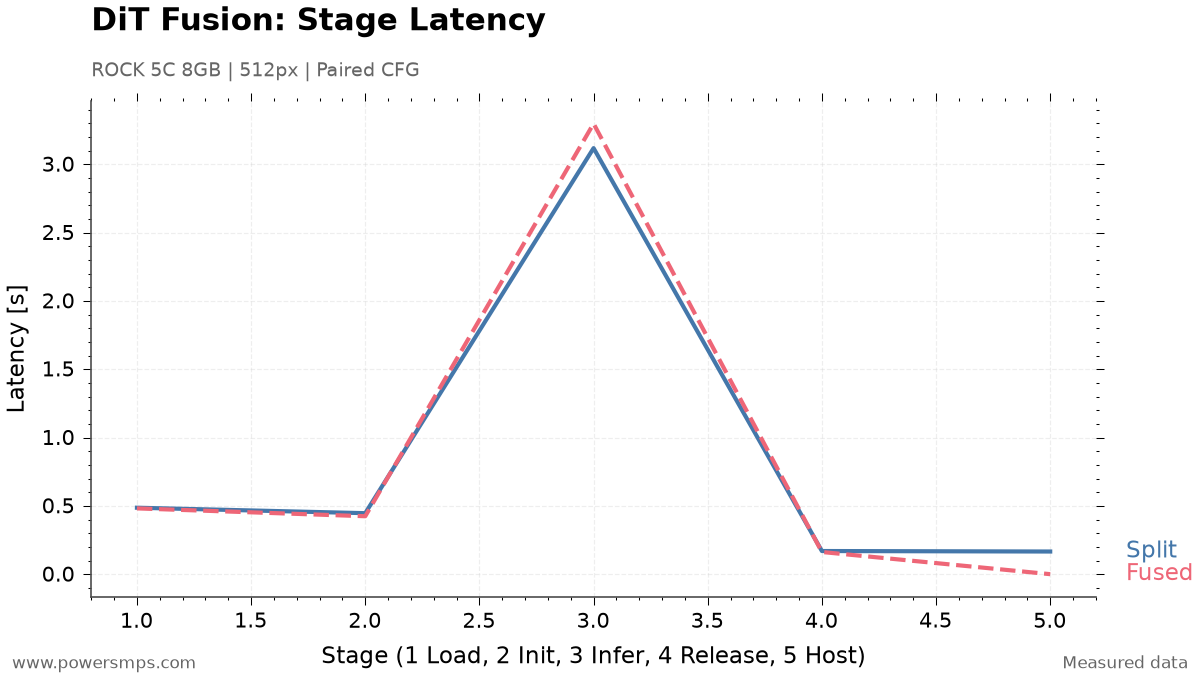
    512px DiT 단일 블록의 구성요소별 실측 시간. 1=load, 2=init, 3=inference×2, 4=release, 5=host AdaLN/residual. 구성요소 합계는 Split 4.3856초, Fused 4.3650초다.
    Comparison of component latency breakdown between Split 3-Model baseline and Fused 1-Model candidate for 512px single block on Radxa ROCK 5C.

    아래 표는 기존 3-model 분할 방식과 Fused 1-model 방식의 단계별 실측 수치 비교다.

    실행 단계 및 구성요소 기존 3-Model Split Fused 1-Model 후보 Fused 변동량 변동 원인 및 분석
    Model Load 0.4863초 0.4814초 -0.0049초 가중치 파일 로딩 시간 (단일 블록 기준 미미한 단축)
    Runtime Init 0.4464초 0.4240초 -0.0224초 NPU 런타임 컨텍스트 초기화 시간 소폭 단축
    NPU Inference (×2) 3.1177초 3.2972초 +0.1795초 (+5.76%) 연산자 융합에 따른 NPU 실행 지연 발생
    Context Release 0.1694초 0.1623초 -0.0071초 컨텍스트 메모리 해제 시간
    Host AdaLN & Residual 0.1658초 0.0000초 -0.1658초 (-100%) 별도 Python 호스트 AdaLN 경로 제거
    순수 구성요소 합계 4.3856초 4.3650초 -0.0206초 (-0.47%) 실제 획득된 순수 단축 시간은 0.0206초에 불과
    계측 Wall Time 4.7379초 4.4981초 -0.2398초 (-5.06%) 분할 모드의 다중 메모리 스냅샷 계측 왜곡치 포함

    실측 데이터는 직관적인 예상과 상반된 병목 현상을 보여주었다. 첫째, 호스트 연산 시간인 0.1658초는 Fused 모델에서 완전히 0초로 제거되었다. 그러나 NPU의 순수 순방향 추론 시간(Inference ×2)이 기존 3.1177초에서 3.2972초로 +0.1795초(+5.76%) 증가했다. 융합 구성에서 추론 시간이 늘어나면서, 호스트 연산 제거로 얻은 이득(0.1658초)을 완전히 상쇄했다.

    둘째, 컨텍스트 호출 횟수는 3회에서 1회로 66.7% 줄어들었으나, 수명주기(Load, Init, Release) 오버헤드는 기대만큼 줄어들지 않았다. 단일 블록의 수명주기 총 시간은 기존 1.1021초에서 1.0678초로 3.1% 단축되는 데 그쳤다. RKNPU 드라이버의 실제 초기화 및 로드 오버헤드는 단순한 C API 호출 횟수보다 모델 파일의 전체 가중치 용량(약 140~155 MB)과 그래프 복잡도에 지배된다는 사실이 드러났다.

    셋째, 계측된 Wall Time상으로는 0.2398초(5.06%)가 줄어든 것처럼 관측되지만, 이는 분할 모드에서 3개의 서브 컨텍스트마다 디버깅용 메모리 스냅샷을 6회 반복 수집한 계측 오버헤드가 포함된 수치다. 스냅샷 계측 왜곡을 배제한 순수 구성요소 합계 기준 실제 단축 효과는 블록당 0.0206초(-0.47%)에 불과했다.


    6. NPU 디바이스 매핑은 94.30 MiB 증가

    지연 시간 단축 효과가 미미한 반면, 런타임 메모리 측면에서는 심각한 손실이 발생했다. 보드 레벨에서 계측된 메모리 지표는 다음과 같다.

    메모리 측정 지표 기존 3-Model Split Fused 1-Model 후보 차이 및 증감률
    NPU 디바이스 매핑 디바이스 PSS 127,144 KiB 223,704 KiB +96,560 KiB (+94.30 MiB, +75.9%)
    실행 시 피크 프로세스 PSS 648,282 KiB 694,882 KiB +46,600 KiB (+45.51 MiB, +7.2%)
    신규 시스템 스왑(Swap) 발생량 0 0 0 (단일 블록 기준 안전)

    분할 방식은 각 브랜치를 순서대로 실행한 뒤 해제한다. 한 번에 유지하는 NPU 디바이스 매핑의 피크는 127,144 KiB, 약 124.16 MiB였다.

    융합 방식은 블록 전체를 하나의 런타임 컨텍스트로 유지한다. 디바이스 매핑은 223,704 KiB, 약 218.46 MiB로 늘어 추가로 94.30 MiB를 차지했다.

    총 8GB의 LPDDR4X 메모리를 공유하는 ROCK 5C 환경에서, 백그라운드 OS와 텍스트 인코더, VAE가 공존해야 하는 상황에 디바이스 매핑 메모리가 75.9%나 급증하는 것은 심각한 시스템 압박 요인이다.


    7. 융합을 채택하지 않은 이유

    단일 블록의 차이를 전체 구성에 외삽한 예상 절감량은 약 7.51초였다. 이는 전체 이미지 생성을 실행해 측정한 결과가 아니다.

    • 속도: 호스트 연산을 줄인 이득이 NPU 추론 지연 증가로 대부분 상쇄됐다.
    • 메모리: 같은 블록을 실행하는 데 필요한 디바이스 매핑이 늘었다.
    • 정밀도: 단일 블록의 코사인 유사도는 높았지만 MSE는 기존 분할 방식보다 커졌다.

    속도 이득은 0.47%에 그쳤고 메모리 사용량은 늘었으므로, 이번 보드에서는 기존 분할 방식을 유지했다.

    검증 범위는 단일 블록에 한정된다. 전체 28개 블록을 융합해 이미지를 생성하는 실험이나 장시간 운용 검증까지 진행한 결과는 아니다.

    3편의 상주 실험과 이번 융합 실험 모두, 호출 횟수를 줄이는 것만으로는 전체 성능을 설명할 수 없었다. NPU 연산 시간과 메모리 비용까지 함께 비교해야 8GB 보드에서 실제로 쓸 수 있는 최적화를 고를 수 있다.

  • RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과

    RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.

    1. ROCK 5C 8GB에서 Anima 실행하기

    8GB 메모리를 탑재한 단일 보드 컴퓨터(Single Board Computer, SBC)인 Radxa ROCK 5C 8GB 환경에서 수십억 파라미터 규모의 Diffusion Transformer(DiT) 모델 온디바이스 구동을 검증했다.

    보드 메인 프로세서는 Rockchip RK3588S2 SoC이며, Rockchip 전용 NPU 런타임 타깃은 rk3588이다. 동일 제조사의 Radxa ROCK 5C 상품군 중 Lite 모델인 RK3582 옵션은 NPU 유닛 및 CPU 코어 구성이 축소된 별개 칩셋이다. 따라서 8GB DiT 연산 파이프라인 재현을 위해서는 반드시 RK3588S2 기반의 ROCK 5C 8GB 모델을 확인해야 한다.

    Anima의 이미지 생성을 담당하는 DiT는 28개 블록으로 구성된다. 이번 실험에서는 이를 ROCK 5C의 NPU에서 실행할 수 있는 형태로 나누어 변환했다.

    온디바이스 변환의 고정 입출력 사양은 다음과 같다: – 배치 크기: 1 – 생성 해상도: 512×512 픽셀 – 입력 토큰 규격: 이미지 토큰 1024개, 텍스트 컨디셔닝 토큰 512개 – ONNX 타깃 버전: Opset 19

    텍스트 인코딩에는 Qwen3, 이미지 복원에는 Qwen-Image VAE를 사용했다. DiT의 주요 연산은 NPU가 처리하고, 텍스트 인코딩과 VAE 디코딩은 CPU가 담당하는 구성이다.


    2. DiT를 84개 RKNN 모델로 나눈 이유

    DiT 아키텍처의 28개 블록 전체를 단일 거대 RKNN 모델로 패키징하는 방식은 RKNN 컴파일러의 구조적 한계에 부딪혔다. 2026년 8월 실험 당시 사용된 RKNN-Toolkit2 2.3.2 환경에서 DiT 블록 전체를 컴파일하거나 AdaLN(Adaptive Layer Normalization) 연산이 결합된 브랜치를 빌드할 때 네이티브 세그폴트(native segfault, exit 139)가 발생했다.

    디버깅을 위해 그래프를 최소 단위로 분해한 결과, 대용량 Linear 레이어나 표준 GELU FFN 그래프는 NPU 타깃으로 정상 빌드되었으나, AdaLN LayerNorm + broadcast shift/scale/gate 패턴이 포함된 서브그래프는 가중치 크기와 무관하게 동일한 세그폴트를 일으켰다. 메모리 부족 문제가 아니라 컴파일러의 특정 그래프 연산자 패턴 해석 오류임이 확인되었다.

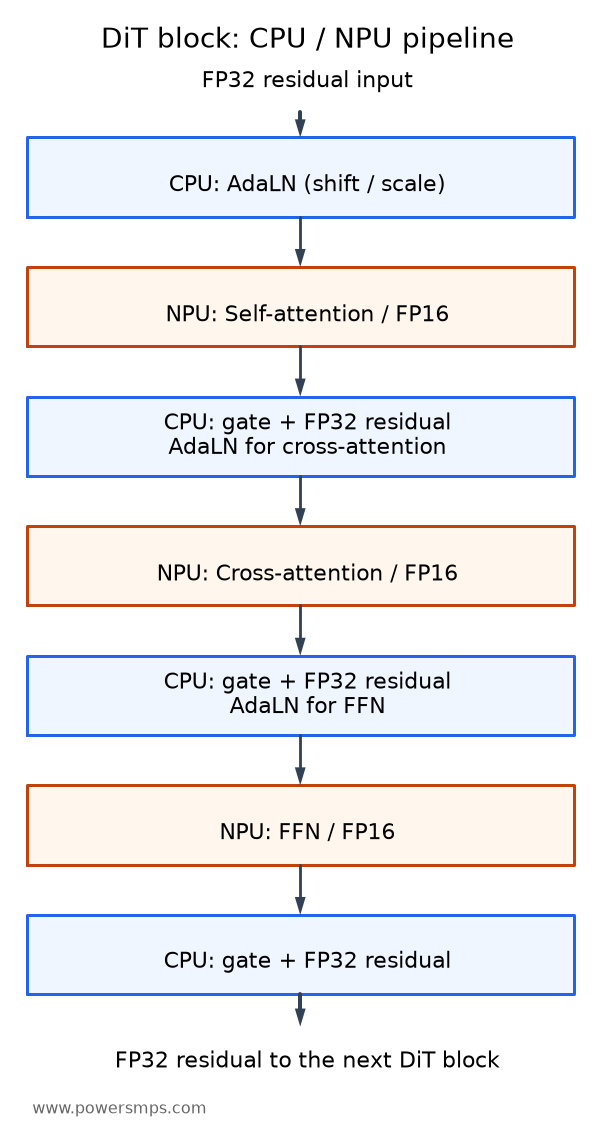
    각 DiT 블록에서 NPU로 실행할 수 있는 3개 연산 분기를 분리하고, 정규화·게이트·잔차 합산은 CPU에서 처리했다.

    28개 DiT 블록을 각각 self-attention, cross-attention, FFN의 3개 서브그래프로 나누었다. self-attention은 이미지 토큰 사이의 관계를, cross-attention은 텍스트 조건과 이미지 토큰의 관계를 계산한다. FFN은 각 토큰의 특징을 변환한다.

    파란 CPU 단계와 주황 NPU 단계를 번갈아 실행하는 DiT 블록 구조. CPU는 각 분기의 AdaLN과 게이트 곱셈·FP32 잔차 누적을, NPU는 FP16 self-attention·cross-attention·FFN을 처리한다.
    DiT 블록 하나의 CPU·NPU 실행 순서. NPU는 FP16 attention·FFN을, CPU는 각 분기 앞의 AdaLN과 분기 뒤의 게이트 곱셈·FP32 잔차 누적을 처리한다. 이 구조가 28개 블록에서 반복된다.

    총 84개(28 × 3)의 FP16 RKNN 모델이 만들어졌으며, 크기 합계는 약 3.99GB다. AdaLN, 게이트 곱셈, RoPE, 입력·타임스텝 임베딩과 최종 프로젝션은 CPU에서 처리했다. 잔차 누적은 FP32로 유지했다.

    • 원본 모델에서 CPU가 처리할 연산과 NPU가 처리할 연산을 분리한다.
    • NPU용 연산을 고정 입출력 형상의 ONNX 그래프로 만든 뒤 RKNN으로 변환한다.
    • 단일 블록과 전체 블록의 출력을 원본과 비교한 다음 이미지 생성을 실행한다.

    3. 변환 전후 출력은 얼마나 비슷한가

    하이브리드 분할 변환에서 가장 중요한 단계는 프레임워크 간 수치 오차의 누적 방지다. 단일 블록 검증과 28개 전체 블록의 순차 누적 검증을 나누어 수행했다.

    단일 블록 비교

    원본 PyTorch 블록의 FP16 분기 연산과 FP32 잔차 누적을 기준으로 ONNX 및 RKNN 출력을 비교했다. 변환한 연산이 원래 모델과 같은 방향의 출력을 내는지 확인하는 과정이다.

    비교 대상 코사인 유사도 (Cosine) 평균 절대 오차 (MAE) 최대 절대 오차 (Max AE) NaN / Inf 발생
    PyTorch → ONNX 0.9999994183 0.00012350 0.09396 0 / 0
    PyTorch → RKNN 0.9999990896 0.00019535 0.11446 0 / 0
    ONNX → RKNN 0.9999995474 0.00014175 0.06969 0 / 0

    PyTorch 기준 출력과 RKNN 출력의 코사인 유사도는 0.9999990896이었다. 단일 블록에서는 변환 전후 출력이 매우 비슷한 방향을 유지했다.

    28개 블록을 통과한 출력 비교

    Block 0부터 Block 27까지 28개 블록 전체를 통과하는 동안 수치 오차가 증폭되지 않는지 확인하기 위해 순수 ONNX 누적 텐서와 RKNN 84코어 누적 텐서를 비교했다.

    • 개별 블록 최저 코사인 유사도: 0.999993668 (전체 28개 블록 중 최저치)
    • 최종 히든 레이어 유사도 (Hidden Cosine): 0.9999989412
    • 최종 16채널 예측 텐서 유사도 (Final Prediction Cosine): 0.9999989072
    • 최종 예측 텐서 MAE: 0.00129712
    • 최종 예측 텐서 Max AE: 0.00830078
    • 경계 구간 NaN / Inf 발생 건수: 0건

    28개 블록을 통과한 뒤에도 NaN이나 Inf는 발생하지 않았고, 기준 출력과 높은 유사도를 유지했다. 다만 이 수치 비교와 최종 생성 이미지의 화질 평가는 구분해야 한다.


    4. 디노이징에는 얼마나 걸렸나

    28블록 전체 forward의 분기별 순수 NPU 시간

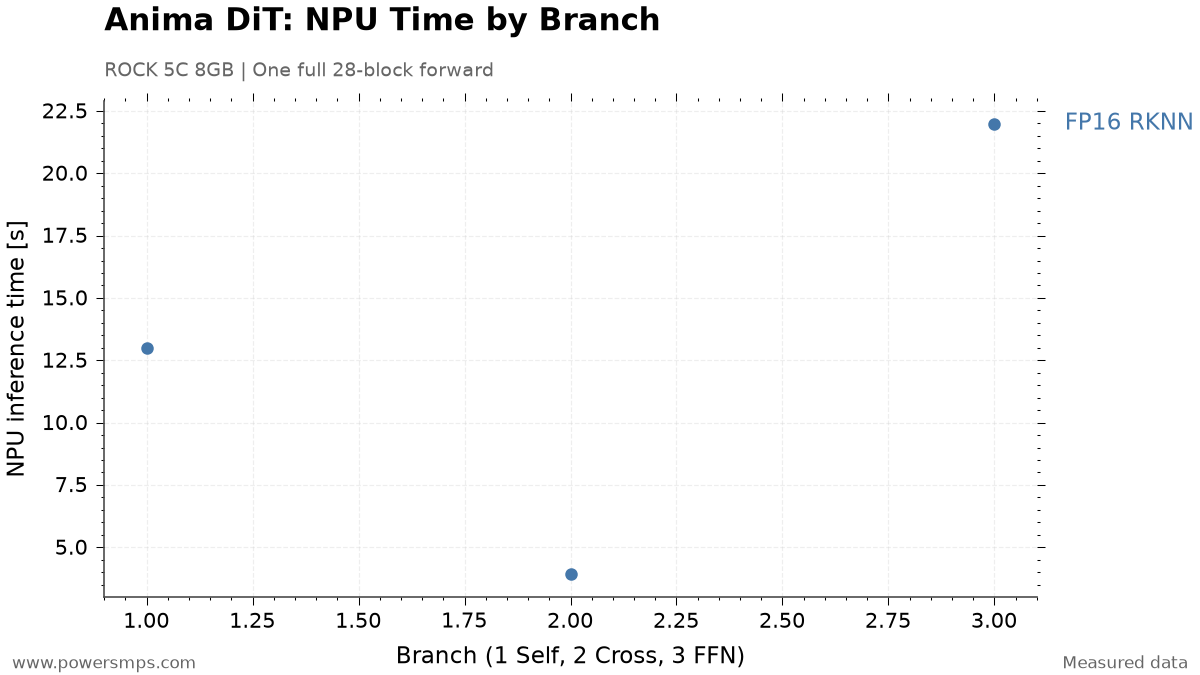
    RK3588 NPU에서 28개 DiT 블록 전체를 통과하는 forward 한 번의 순수 추론 시간 합계는 약 38.90초다. 아래 분기별 값은 각각 28개 블록의 실행 시간을 합산한 값이다.

    각 코어별 세부 소요 시간은 다음과 같다: – Self-Attention Core: 12.99초 – Cross-Attention Core: 3.92초 – FFN Core: 21.99초

    ROCK 5C의 28블록 전체 DiT forward 한 번에서 분기별 NPU 추론 시간 합계. 1: self-attention, 2: cross-attention, 3: FFN. 단일 블록 시간이 아니다.
    ROCK 5C의 28블록 전체 DiT forward 한 번에서 분기별 NPU 추론 시간 합계. 1: self-attention, 2: cross-attention, 3: FFN. 단일 블록 시간이 아니다.

    파라미터 비중이 큰 FFN 코어가 전체 순수 NPU 추론 시간의 약 56.5%를 차지한다. 참고로 ONNX 수치 검증 로직이 동반된 28블록 전체 테스트의 전체 실행 시간(Wall Time)은 162.8초였으며, 이는 순수 NPU 연산 시간(38.90초)과 구분된다.

    20스텝 순차 CFG 디노이징 결과

    실제 이미지 생성 과정인 20스텝 순차 분류기 없는 가이던스(Sequential Classifier-Free Guidance, CFG, guidance scale 4.0) 디노이징을 보드에서 직접 수행했다. 조건부(Positive) 및 무조건부(Negative) 예측을 단일 배치로 묶지 않고 메모리 한계를 감안하여 순차 호출 방식으로 처리했다.

    • 20스텝 디노이징: 2,408.54초
    • 스텝당 평균: 120.40초
    • 스텝당 순수 NPU 연산: 76.21초
    • 스텝당 모델 준비·호스트 처리 등: 약 44.19초
    • 20스텝 전체 구간 NaN/Inf: 0건

    스텝당 약 44.19초의 비-NPU 시간에는 84개 RKNN 모델의 로드·초기화·해제(load/init/release)뿐 아니라 호스트 연산과 경계 처리 비용도 포함된다. 후속 최적화에서는 이 비용을 나누어 계측해야 한다.


    5. VAE를 바꿔 이미지 복원 시간 줄이기

    디노이징이 완료된 잠재 변수(Latent)를 512×512 픽셀 RGB 이미지로 복원하는 VAE 디코딩 과정은 CPU 연산 부담이 큰 단계다. 공식 Diffusers의 Qwen-Image VAE FP32 CPU 구현을 그대로 사용했을 때의 디코딩 시간은 2,154.51초(약 35분 54초)에 달해, 20스텝 DiT 디노이징 전체 시간과 맞먹는 심각한 병목을 유발했다.

    VAE 디코딩에는 stable-diffusion.cpp의 ARM NEON·OpenMP 최적화 CPU 구현을 적용했다. 텍스트 인코더와 트랜스포머를 다시 초기화하지 않고, 디노이징이 끝난 잠재 텐서만 받아 이미지로 복원하도록 연결했다.

    CPU 4스레드, 타일 크기 32×32, 오버랩 0.5 설정으로 측정한 VAE 백엔드 비교 결과는 다음과 같다:

    평가 지표 공식 Diffusers FP32 VAE sd-cpp 타일형 CPU VAE 개선폭
    디코딩 소요 시간 2,154.51초 155.04초 13.90배 단축 (1,999.47초 절감)
    PSNR (Diffusers 출력 대비) 기준 출력 31.444 dB 참조 출력과 비교
    11×11 Gaussian SSIM 1.00000 0.96109 참조 출력과 비교
    출력 해상도 및 규격 512×512 RGB 512×512 RGB NaN / Inf 0건

    육안 검토에서는 구성·색·세부 표현이 유지된 것으로 평가했다. PSNR과 SSIM은 두 출력이 완전히 동일하다는 뜻은 아니다. 디코딩 시간은 2분 35초 수준으로 단축했다.

    디노이징과 이미지 복원 시간 합계

    VAE 가속을 통합한 전체 이미지 생성 시간은 다음과 같다: – DiT 20스텝 순차 CFG 디노이징: 2,408.54초 – sd-cpp 타일형 VAE 디코딩: 155.04초 – 총 생성 시간 (프롬프트 1회 인코딩 제외): 2,563.58초 (약 42분 44초)


    6. 다음 병목은 디노이징

    VAE 디코딩 시간을 2,154.51초에서 155.04초로 단축함에 따라, 전체 파이프라인에서 VAE가 차지하는 비중은 기존 47.2%에서 6.0%로 대폭 축소되었다. 이에 따라 전체 시스템의 지배적 병목은 DiT 20스텝 디노이징(2,408.54초, 전체의 94.0%)으로 전환되었다.

    DiT 디노이징 내부를 분해하면, 순수 NPU 연산에 소요되는 시간은 스텝당 76.21초(20스텝 합계 1,524.20초)이며, 나머지 약 884.34초는 모델 수명주기와 호스트 처리 등을 포함한 비-NPU 시간이다. 컨텍스트 상주는 반복 초기화 비용을 줄이기 위한 후보였지만, 8GB 환경에서는 메모리 여유와 실제 절감량을 별도로 검증해야 했다. 그 실험 결과는 3편에서 다룬다.

    이후 최적화에서는 연산 횟수와 메모리 사용량을 함께 살펴봤다. 2편은 Spectrum으로 계산 스텝을 줄인 결과, 3편은 양자화와 모델 상주가 화질·메모리 제한에 부딪힌 결과를 다룬다. 4편에서는 컴파일러 버전 비교와 그래프 융합의 손익을 살펴본다.