[작성자:] mk

  • 220Vac SMPS 입력 평활콘덴서 용량 선정: 계산과 시뮬레이션 예제

    220Vac SMPS 입력 평활콘덴서 용량 선정: 계산과 시뮬레이션 예제

    평활콘덴서는 허용 리플에서 용량을 계산한 뒤, 공차와 최저 버스전압을 확인해야 한다. 220Vac를 브리지 정류하는 60W SMPS를 예로 들어 계산하고, 정류 파형으로 리플과 충전전류를 확인한다.

    앞선 글 ‘평활 커패시터의 선택 방법’에서 내압과 Schade 그래프를 이용한 선정 원리를 다뤘다. 여기서는 일정전력 부하의 에너지 식으로 초기 용량을 구한다. 수치는 설계 예제의 조건을 기준으로 한다.

    1. 설계 조건: 220Vac, 60W, 리플 40Vpp

    대상은 PFC가 없는 단상 브리지 정류기와 입력 벌크콘덴서다. 연결 순서는 AC 전원 → 소스저항 → 브리지 정류기 → 벌크콘덴서와 DC/DC 입력 부하다. 콘덴서의 ESR은 직렬로 넣고, 버스의 DC 리턴은 보호접지와 구분한다. 상용전원에 직접 연결되는 고압 비절연 구간을 다루는 계산 예제이므로 회로 동작 검증과 수치 해석을 위한 예제로 구성했다.

    항목 예제 조건
    정격 입력과 변동 220Vac ±10%, 즉 198~242Vac
    전원 주파수 50/60Hz, 용량 계산은 50Hz 기준
    DC/DC 출력전력 60W
    DC/DC 단 효율 85%로 가정
    허용 버스 리플 40Vpp
    콘덴서 초기 용량 공차 −20%
    계산용 브리지 전압강하 도통 다이오드 두 개의 합 2V

    220Vac 사례는 상용전원 SMPS의 동작을 설명하기에 적절한 기준이다. 다만 85~264Vac 유니버설 입력이나 PFC 버스는 동작 영역이 다르므로 별도 계산이 필요하다. 허용 리플 40Vpp는 이번 설계의 목표값이며, 후단 DC/DC가 리플 최저점에서도 안정적으로 동작할 수 있는지는 실제 컨버터의 입력 범위로 확인해야 한다.

    2. 일정전력 부하는 에너지 식으로 계산한다

    DC/DC가 출력전력을 유지한다고 보면 버스에서 가져가는 평균 전력은 다음과 같다. 여기서 85%는 브리지와 입력단 손실을 제외하고 DC/DC 단의 변환 전력을 평가하기 위해 둔 효율이다.

    \[ P_{\mathrm{bus}}=\frac{P_{\mathrm{out}}}{\eta_{\mathrm{DC/DC}}} =\frac{60}{0.85}\approx70.59\,\mathrm{W} \]

    버스전류는 \(I=P_{\mathrm{bus}}/V_{\mathrm{bus}}\)이므로 방전 중 전압이 떨어지면 증가한다. 따라서 일정전류를 가정한 \(C=I\Delta t/\Delta V\)에 한 전류값을 고정하기보다 콘덴서의 에너지 변화를 사용하는 편이 적절하다.

    \[ P_{\mathrm{bus}}\Delta t=\frac{1}{2}C_{\mathrm{eff}} \left(V_{\mathrm{hi}}^2-V_{\mathrm{lo}}^2\right),\qquad C_{\mathrm{eff}}=\frac{2P_{\mathrm{bus}}\Delta t}{V_{\mathrm{hi}}^2-V_{\mathrm{lo}}^2} \]

    전파정류의 리플 주파수는 전원 주파수의 두 배다. 먼저 충전시간을 생략하여 방전시간을 \(\Delta t\approx1/(2f_{\mathrm{line}})\)로 잡는다. 50Hz에서는 10ms다. 방전시간을 보수적으로 길게 잡아 초기 용량을 빠르게 가늠하기 위한 1차 근사다. Power Integrations AN-92의 Appendix A도 정류기 차단 중 일정전력 부하의 에너지 관계로 벌크콘덴서를 계산한다.

    저입력 198Vac에서 계산용 충전 피크와 목표 최저전압은 다음과 같다.

    \[ V_{\mathrm{hi}}\approx198\sqrt{2}-2=278.01\,\mathrm{V},\qquad V_{\mathrm{lo}}=278.01-40=238.01\,\mathrm{V} \]

    \[ C_{\mathrm{eff,min}}\approx \frac{2\times70.59\times0.010}{278.01^2-238.01^2} \approx68.4\,\mu\mathrm{F} \]

    초기 공차 −20%를 적용하면 명목 용량은 \(C_{\mathrm{nom}}\ge68.4/0.8\approx85.5\,\mu\mathrm{F}\)가 필요하다. 따라서 100µF를 초기 후보로 잡는다. 여기서는 초기 공차를 반영해 1차 후보를 정한 상태이며, 실제 설계에서는 온도 특성과 수명에 따른 용량 변화까지 감안해 최종 마진을 확정한다.

    3. 후보 용량은 최소 실효값으로 비교한다

    리플은 아래 식으로 다시 계산해 비교할 수 있다. 비교표의 실효용량은 명목값의 80%이며, 근사 계산에는 동일한 저입력 피크 278.01V를 사용했다.

    \[ V_{\mathrm{lo}}\approx\sqrt{V_{\mathrm{hi}}^2- \frac{2P_{\mathrm{bus}}}{2f_{\mathrm{line}}C_{\mathrm{eff}}}},\qquad \Delta V_{\mathrm{pp}}=V_{\mathrm{hi}}-V_{\mathrm{lo}} \]

    명목 용량 −20% 실효용량 50Hz 근사 리플 60Hz 근사 리플 50Hz 해석 리플
    68µF 54.4µF 51.4Vpp 42.1Vpp 40.4Vpp
    82µF 65.6µF 41.9Vpp 34.4Vpp 33.7Vpp
    100µF 80µF 33.8Vpp 27.8Vpp 27.8Vpp
    120µF 96µF 27.8Vpp 23.0Vpp 23.2Vpp

    근사 기준에서 82µF는 50Hz·40Vpp 목표를 넘고, 100µF는 만족한다. 100µF 후보의 실효용량 80µF를 적용하면 50Hz 근사 리플은 약 33.8Vpp, 최저전압은 약 244.2V다. 60Hz에서는 재충전 간격이 짧아져 리플이 감소한다. 표의 해석값에는 다음 절의 회로 조건을 적용했다.

    4. 회로 파형과 계산값은 얼마나 다를까
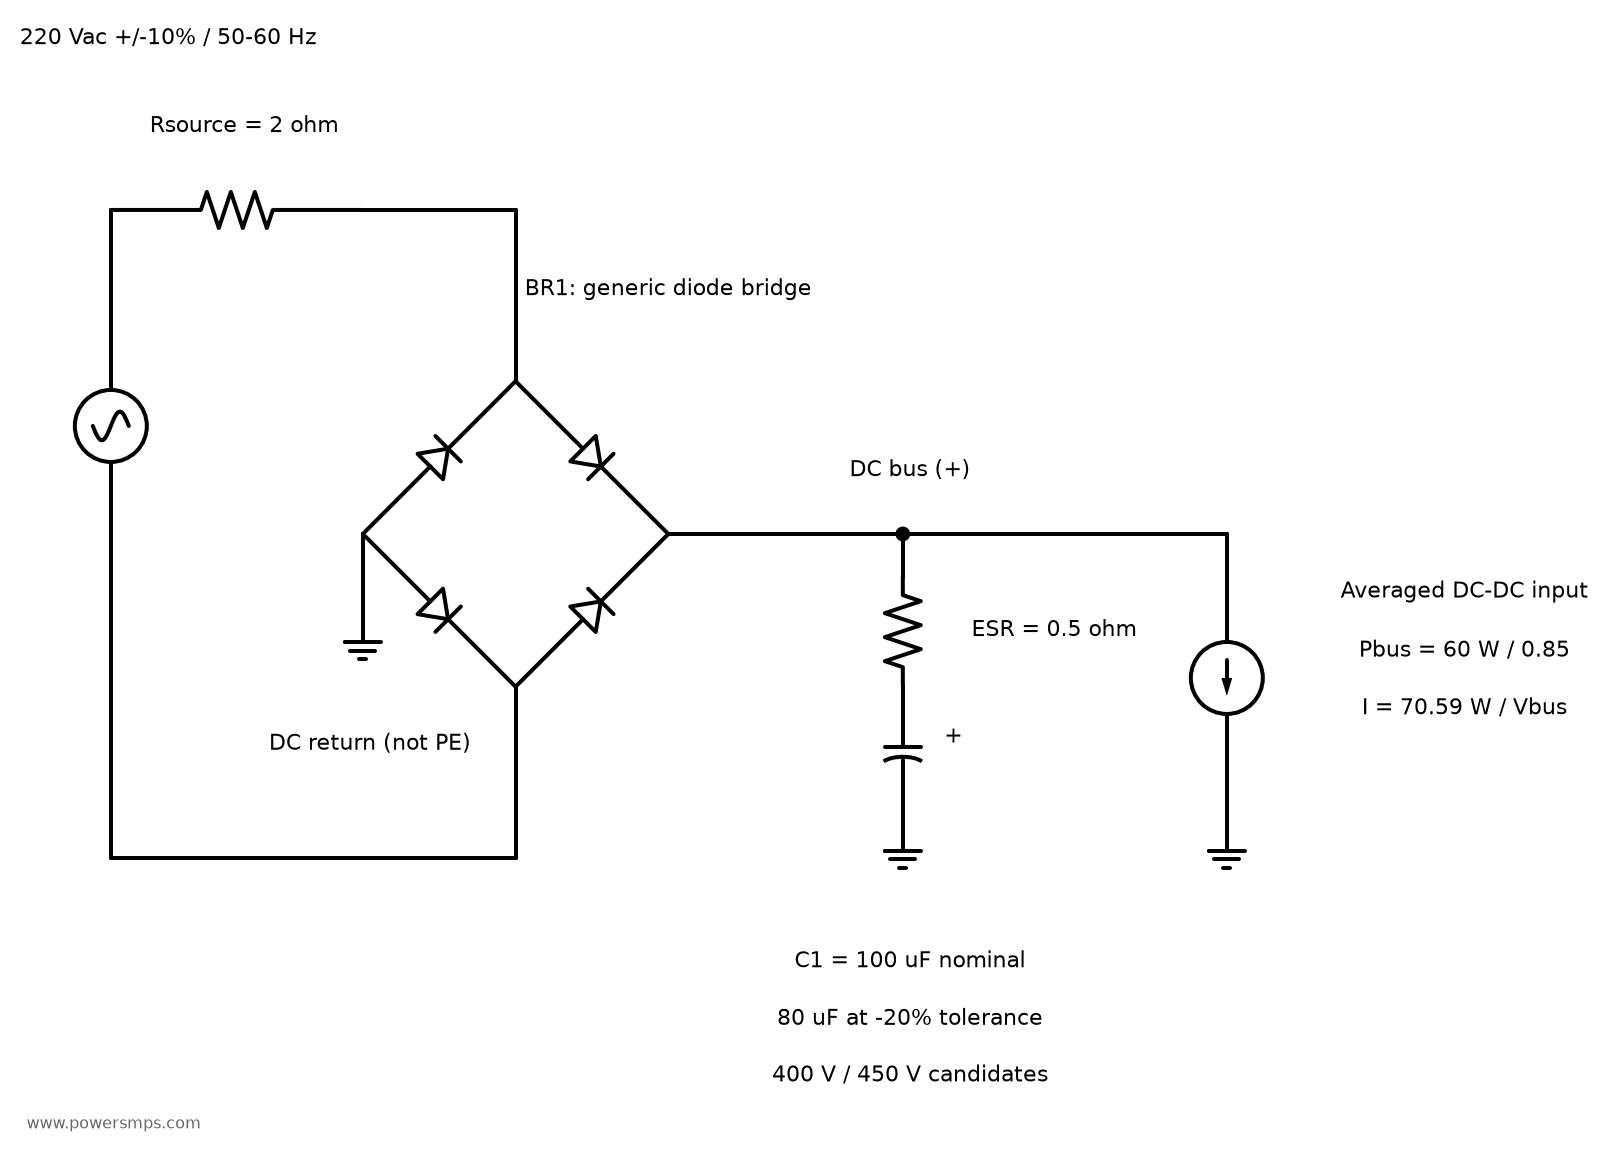
    220Vac 브리지 정류기, 소스저항, ESR 직렬 평활콘덴서와 일정전력 DC/DC 입력 부하
    220Vac 입력의 브리지 정류·평활 회로. DC 리턴은 보호접지와 구분한다.

    아래 파형은 브리지 정류기 회로를 ngspice로 과도해석한 결과다. 입력 소스저항은 2Ω, 콘덴서 ESR은 0.5Ω으로 가정했다. 네 다이오드는 동일한 일반 모델을 사용했다. 모델 파라미터는 IS=5nA, N=1.8, RS=0.1Ω, BV=1000V, IBV=10µA다. 특정 부품에 국한하기보다 회로의 기본 거동을 확인하기 위한 모델링이다.

    부하는 \(I_{\mathrm{load}}=70.59/V_{\mathrm{bus}}\)인 평균화 일정전력 모델이다. 기동 계산의 안정을 위해 200V 이하에서는 분모를 제한하고 50~55ms에 부하를 서서히 인가했다. 결과는 0.5~0.6초의 정상상태에서 평가했다. 이 구간에서 버스가 200V보다 높고 부하전력이 설정값을 유지하는지 확인했다. 해석의 최대 시간간격은 20µs다. 행동소스와 과도해석 방법은 과도해석 매뉴얼을 참고할 수 있다.

    198Vac·50Hz·실효 80µF 항목 해석 결과
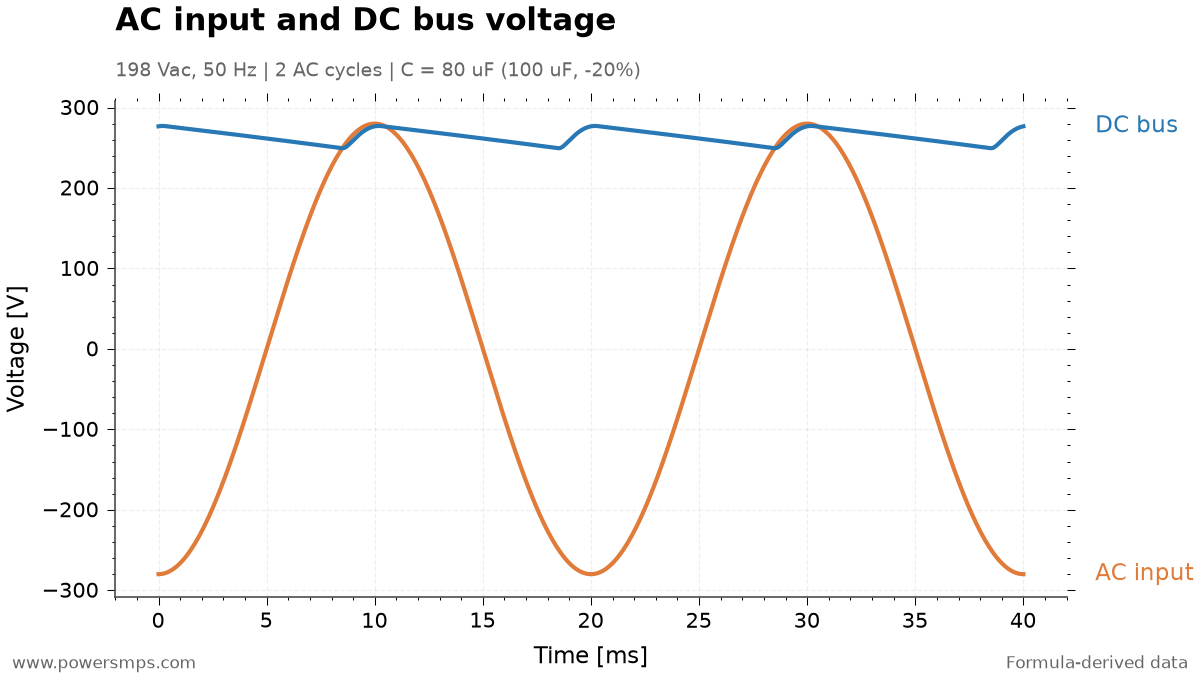
    버스 최고전압 약 277.1V
    버스 최저전압 약 249.3V
    버스 리플 약 27.8Vpp
    콘덴서 저주파 리플전류 약 0.654Arms
    브리지 출력 충전전류 피크 약 2.43A
    입력 AC 전압과 버스전압을 같은 전압축에 겹쳐 표시했다. 50Hz 입력 AC 기준 2주기(40ms), 실효용량 80µF.
    입력 AC 전압과 버스전압을 같은 전압축에 겹쳐 표시했다. 50Hz 입력 AC 기준 2주기(40ms), 실효용량 80µF.

    단순 계산값 33.8Vpp보다 회로 해석값 27.8Vpp가 작다. 실제 모델에서는 정류기가 일정 시간 도통하며 부하를 공급하고 콘덴서를 충전하므로, 반주기 전체를 방전한다고 가정한 계산보다 방전시간이 짧기 때문이다. 반대로 소스저항과 다이오드의 전압강하는 충전 가능한 최고전압을 낮춘다. ST AN1262에서도 입력 벌크콘덴서와 최소 버스전압을 검토할 때 정류기의 도통시간을 고려한다.

    회로 해석에서 82µF 후보가 40Vpp 이내로 나와도 곧바로 채택하기는 섣부르다. 여기의 저항과 다이오드는 가정한 값이다. 초기 후보는 보수적인 1차 계산으로 잡고, 실제 부품과 입력 조건을 반영한 모델 및 측정으로 좁혀가는 편이 안전하다.
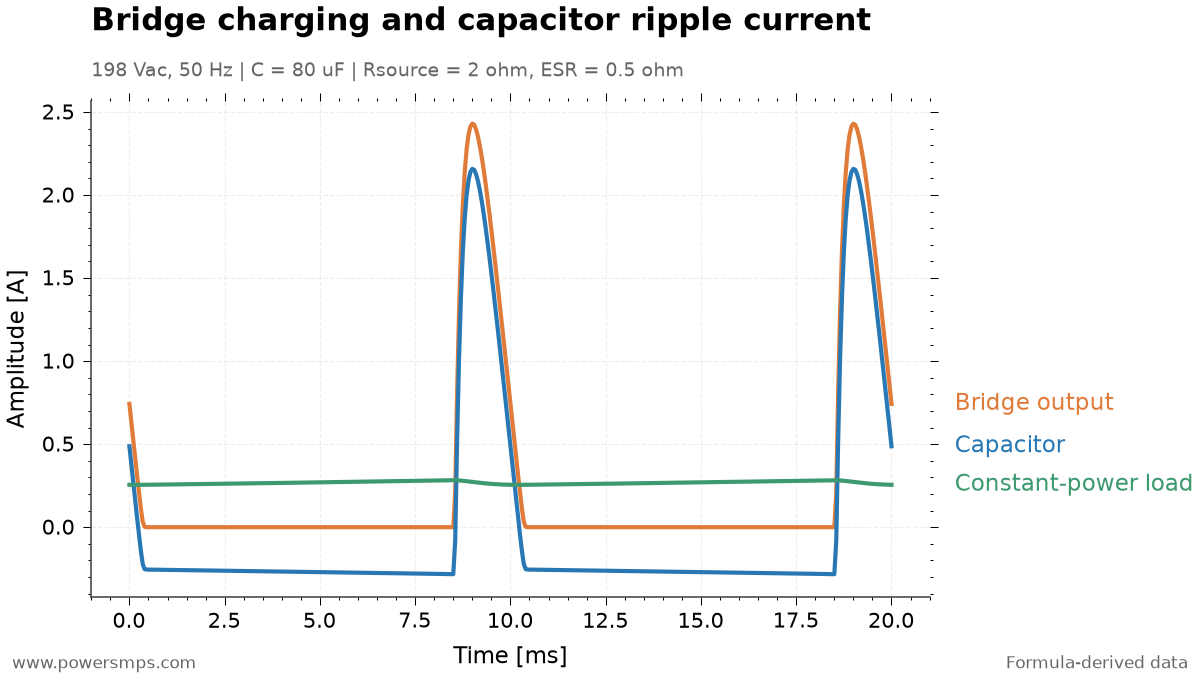
    브리지 출력전류, 콘덴서 전류, 부하전류. 콘덴서 전류의 양수는 충전, 음수는 방전이며 고주파 스위칭 전류는 포함하지 않는다.
    브리지 출력전류, 콘덴서 전류, 부하전류. 콘덴서 전류의 양수는 충전, 음수는 방전이며 고주파 스위칭 전류는 포함하지 않는다.

    콘덴서 전류는 \(i_C=i_{\mathrm{bridge}}-i_{\mathrm{load}}\)다. 방전 중에는 부하로 전류를 내보내고, 충전 중에는 펄스전류를 받는다. 그래서 부하전류만으로 콘덴서의 허용 리플전류를 판단할 수는 없다. 위 RMS 값은 \(I_{C,\mathrm{rms}}=\sqrt{(1/T)\int i_C^2dt}\)로 계산한 저주파 성분이다. 평균화 부하 모델에는 DC/DC의 고주파 스위칭 전류가 포함되지 않은 상태다.

    5. 내압과 리플전류는 별도로 확인한다

    고입력 242Vac에서 무부하 피크를 다이오드 전압강하 없이 계산하면 \(V_{\mathrm{pk,max}}\approx242\sqrt{2}=342.2\,\mathrm{V}\)다. 이 정상상태 전압을 기준으로 400V와 450V 등급을 후보로 비교할 수 있다. 실제 정격 전압을 결정할 때는 정상상태 피크 외에도 서지 마진, 전압 디레이팅 규격, 동작 온도를 종합해 검토한다.

    리플전류 정격은 데이터시트의 주파수와 온도 조건까지 맞춰 비교한다. 이 모델의 저주파 ESR 손실만 단순 계산하면 \(P_{\mathrm{ESR}}\approx0.654^2\times0.5\approx0.214\,\mathrm{W}\)다. 실제 손실에는 주파수에 따른 ESR과 고주파 전류도 반영해야 한다. 온도·수명 검토는 평활콘덴서 수명과 배치에 관한 글에서 이어서 살펴볼 수 있다. 용량을 늘릴 때에는 기동 돌입전류와 정류기 스트레스도 함께 확인한다.

    리플 목표와 홀드업 시간도 구분해야 한다. 이번 50Hz 계산의 10ms는 정류 피크 사이의 주기적 간격이다. 전원 차단 후 20ms 동안 출력을 유지하는 조건과는 다르다. 홀드업은 \(t_{\mathrm{hold}}\approx C_{\mathrm{eff}}(V_{\mathrm{start}}^2-V_{\mathrm{stop}}^2)/(2P_{\mathrm{bus}})\)로 별도 검토하며, 최악조건의 리플 골에서 전원이 끊기는 경우와 후단의 실제 최소 동작전압을 사용해야 한다.

    6. 이 예제의 선정 결과

    220Vac ±10%, 60W, DC/DC 효율 85%, 50/60Hz, 허용 리플 40Vpp 조건에서는 100µF를 초기 용량 후보로 정할 수 있다. −20% 공차를 반영한 80µF에서 50Hz 근사 리플은 약 33.8Vpp이고, 회로 해석값은 약 27.8Vpp다.

    계산으로 1차 용량 후보를 정한 뒤 실제 부품을 최종 선정할 때 점검할 기준은 다음과 같다.

    • 저입력(198Vac)에서 리플 최저점이 후단 DC/DC의 최소 입력전압 이상을 유지하는지 확인한다.
    • 고입력(242Vac) 무부하 피크 전압(342.2V)을 기준으로 서지 마진과 디레이팅 규격을 만족하는 내압 등급(400V 또는 450V)을 결정한다.
    • 저주파 리플과 고주파 스위칭 성분에 의한 발열, 그리고 기동 시 돌입전류를 감당할 수 있는지 점검한다.
  • 74HC595 출력이 1비트씩 밀리는 문제: Burst Noise와 CLK RC 필터 개선 사례

    74HC595 출력이 1비트씩 밀리는 문제: Burst Noise와 CLK RC 필터 개선 사례

    MCU의 출력 포트가 부족해 74595 계열 시프트 레지스터를 사용한 적이 있다. 그런데 EN 55014-2 기준으로 AC 전원 포트에 Burst 1kV를 인가하는 시험에서 출력 데이터가 1비트씩 밀리는 현상이 발생했다.

    슈미트 트리거 입력을 갖는 TI SN74HCS595로 변경하자 오동작 빈도는 줄었지만 현상은 남았다. SN74HCS595를 유지한 상태에서 CLK 경로에 100Ω 직렬 저항과 1nF 커패시터로 RC 필터를 추가한 뒤에는 해당 시험 조건에서 현상이 더 이상 발생하지 않았다. 여러 IC에 CLK를 분기할 때의 필터 배치와 개선 과정을 정리한다.

    CLK 오인식이 출력 비트 밀림으로 이어지는 이유

    74595는 시프트 레지스터와 출력 저장 레지스터가 분리된 구조다. SN74HCS595의 경우 SRCLK 상승 에지에서 직렬 입력 데이터가 시프트되고, 별도의 RCLK가 출력 저장 레지스터를 갱신한다. 이 동작 구조는 TI SN74HCS595 데이터시트에서 확인할 수 있다.

    시프트 과정에서 의도하지 않은 CLK 에지가 추가로 인식되면 데이터가 한 비트 더 이동할 수 있다. 이후 RCLK로 출력을 갱신하면 밀린 데이터가 병렬 출력에 반영된다.

    출력이 1비트씩 밀리는 현상과 CLK 필터 적용 후 개선된 결과를 바탕으로, 이번 문제는 Burst Noise가 shift CLK 배선에 결합해 추가 클록으로 인식되는 현상으로 판단했다.

    SN74HCS595로 변경한 결과: 빈도는 줄었지만 현상은 남음

    먼저 슈미트 트리거 입력이 내장된 TI SN74HCS595로 변경했다. 이 제품은 모든 입력에 슈미트 트리거 구조를 적용하며, 느리거나 노이즈가 있는 입력 신호를 지원한다. TI 데이터시트

    슈미트 트리거는 입력 전압이 올라갈 때와 내려갈 때 서로 다른 전환 문턱을 사용한다. 이 히스테리시스가 입력 문턱 부근의 흔들림에 의한 반복 전환을 줄여 준다. 그러나 노이즈가 두 전환 문턱을 넘나들면 슈미트 트리거 입력도 클록으로 인식할 수 있다.

    실제로 IC를 변경한 뒤 오동작 빈도는 감소했지만 비트 밀림 현상이 완전히 없어지지는 않았다. 이번 환경에서는 입력의 히스테리시스만으로 충분하지 않아, CLK 입력에 도달하는 노이즈를 줄이는 대책을 추가했다.

    CLK에 100Ω과 1nF RC 필터 추가

    SN74HCS595를 유지하면서 CLK 신호 경로에 100Ω 저항을 직렬로 넣고, 저항을 지난 SRCLK 입력 노드와 GND 사이에 1nF 커패시터를 연결했다.

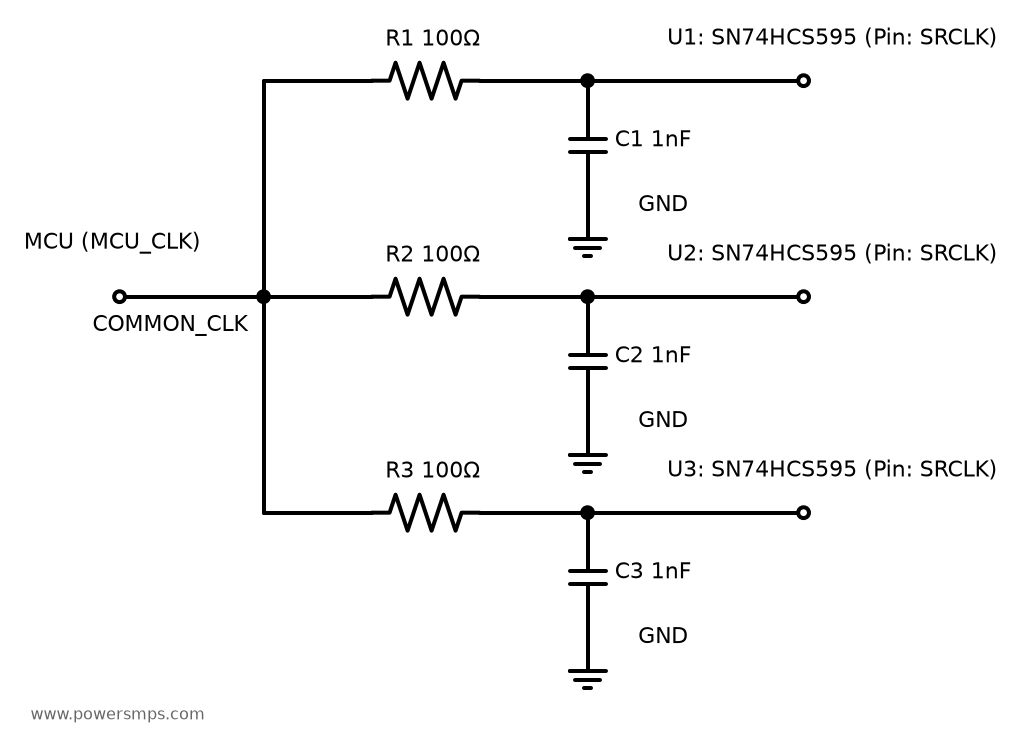
    공통 CLK를 여러 IC에 Stub 배선으로 분기하는 경우에는 각 IC의 CLK 입력 가까이에 필터를 개별적으로 적용하는 방식이 유효했다. 분기 이후의 배선에도 노이즈가 결합할 수 있으므로, 각 수신단에서 필터링하도록 구성하는 것이 핵심이다.

    MCU 공통 CLK의 각 분기에 100Ω 직렬 저항과 SRCLK 입력–GND 사이 1nF 커패시터를 적용한 회로도
    CLK 분기별 100Ω 직렬 저항과 입력–GND 사이 1nF 필터. 세 분기는 구성 예시이며 DATA(SER), 출력 래치(RCLK), 전원 및 디커플링 연결은 생략했다.

    회로도는 분기별 필터 연결을 설명하는 개념도다. 세 개의 분기는 구성 예시이며 DATA(SER), 출력 래치(RCLK), 전원 및 디커플링 연결은 생략했다.

    각 분기의 연결은 공통 CLK → 100Ω 직렬 저항 → SRCLK 입력 순서다. 1nF 커패시터는 저항을 지난 입력 노드에서 해당 IC의 로컬 GND로 연결한다. 커패시터와 GND 사이의 배선도 짧게 구성하는 것이 좋다.

    RC 필터는 짧은 노이즈 펄스에 대한 입력 노드의 전압 변화를 완화하고, 슈미트 트리거는 필터를 거친 입력 신호를 히스테리시스에 따라 판별한다. 두 대책은 서로 다른 역할을 한다.

    대책별 Burst 시험 결과

    적용 단계 관찰 결과
    기존 74595 계열 사용 Burst 시험 중 출력 데이터가 1비트씩 밀리는 현상 발생
    SN74HCS595로 변경 오동작 빈도 감소, 비트 밀림 현상은 남음
    SN74HCS595 유지 + CLK에 100Ω·1nF RC 필터 추가 해당 시험 조건에서 비트 밀림 현상 미발생

    위 결과는 EN 55014-2 기준, AC 전원 포트에 Burst 1kV를 인가한 시험 조건에서 확인한 내용이다. 이번 회로에서는 IC 변경만으로 남아 있던 현상이 RC 필터 추가 후 없어졌다.

    다른 회로에 적용할 때 확인할 타이밍

    100Ω과 1nF의 이상적인 RC 시정수는 100ns다. 이번 회로에서는 이 부품값으로 문제를 해결했지만, 필터는 노이즈뿐 아니라 정상 CLK의 에지와 도착 시간에도 영향을 미친다. 따라서 다른 회로에 적용할 때는 다음 항목을 함께 확인해야 한다.

    • 정상 CLK의 펄스 폭과 입력 전환 시간: 필터를 거친 뒤에도 필요한 클록 조건을 만족하는지 확인한다.
    • 데이터와 출력 래치 타이밍: SER의 설정·유지 시간과 마지막 SRCLK에서 RCLK까지의 시간 여유를 데이터시트 기준으로 확인한다.
    • 여러 IC 사이의 CLK 도착 시간 차이: 개별 RC의 부품 편차와 입력 문턱 차이에 따른 스큐를 고려한다. 특히 직렬 캐스케이드에서는 IC 사이의 데이터 설정·유지 시간을 확인해야 한다.
    • MCU CLK 출력의 구동 부하: 분기 수가 늘어나면 각 커패시터를 구동하는 부하도 증가하므로 GPIO의 구동 능력과 실제 전송 조건을 검토한다.
  • RK3688 출시 현황과 비교 준비: ROCK 5C 실측으로 정한 성능·온도 기준

    RK3688 출시 현황과 비교 준비: ROCK 5C 실측으로 정한 성능·온도 기준

    RK3688 비교를 준비하는 이유

    RK3688을 기다리는 이유는 단순하다. ROCK 5C에서 오래 걸리던 이미지 생성이 새 보드에서는 얼마나 가벼워질지 궁금하기 때문이다. 칩 소식을 살펴보는 김에, 그동안 쌓아 둔 실측 기록도 다시 꺼내 봤다.

    2026년 10월 27일 현재 나는 RK3688 장비를 구입할 계획을 세우고 있다. 지금까지 직접 돌려 본 ROCK 5C의 기록을 출발점으로 삼아, 새 장비를 들였을 때 비교해 보고 싶은 것들을 정리했다.

    RK3688은 언제 만나 볼 수 있을까

    최근 소식을 따라가면서 내 눈에 들어온 것은 제품의 순서다. Rockchip의 공시와 Radxa 쪽 자료를 함께 보면, 먼저 나올 보드와 조금 더 기다려 볼 보드의 윤곽을 생각해 볼 수 있다.

    Rockchip은 Rockchip 2026년 3분기 분기보고서에서 RK3668을 곧 생산에 투입하고 RK3688을 뒤이어 내놓겠다고 설명했다. 내가 기다리는 RK3688에 앞서 RK3668이 시장에 먼저 모습을 드러내는 흐름이다.

    Radxa 공식 다운로드 서버 rock6/6b 디렉터리에서 찾은 Rockchip RK3668 SoC Application REL02도 흥미롭다. 2026-10-09자 문서에는 RK3668의 CPU가 6개의 Cortex-A725와 2개의 Cortex-A520으로 구성되고, NPU는 44 TOPS Sparse, 엔지니어링 샘플은 2027년 1분기로 적혀 있다.

    특히 문서가 rock6/6b 폴더에 올라와 있다는 점이 눈에 띈다. 개인적으로는 ROCK 6 계열에서 어떤 칩과 메모리 구성을 만나게 될지 기대하게 된다. SBC에 이어 확장성이 좋은 보드까지 선택지가 이어지면 더 반가울 것 같다.

    Rockchip도 Rockchip 공식 고성능 SoC 로드맵 발표에서 RK3668과 RK3688을 다음 고성능 플랫폼으로 소개했다. 나는 이 두 칩이 RK3588 계열을 쓰던 사람에게 어떤 업그레이드 선택지가 될지 관심 있게 보고 있다.

    일정을 보고 내가 예상하는 그림은 RK3668 쪽 보드가 먼저 나오고, RK3688 보드가 그 뒤를 잇는 모습이다. 개인적으로는 당장의 판매일을 좇기보다 내년에 실제로 살 수 있는 보드가 나오는지 지켜보는 쪽에 무게를 둔다. 출시 소식만큼 SDK와 메모리 구성도 기대하고 있다.

    RK3588과 RK3688, 얼마나 빨라질까

    사양으로 그려 보는 RK3588과 RK3688의 차이

    먼저 내가 기다리는 성능 차이부터 정리해 봤다. RK3688 쪽은 2025년 Rockchip 개발자 행사에서 공개된 사양 슬라이드를 바탕으로 한 계획 사양이다. 지금 쓰는 ROCK 5C의 RK3588S2 구성과 나란히 놓으면 왜 업그레이드를 기대하는지 더 잘 보인다.

    항목현재 RK3588 계열·ROCK 5CRK3688 공개 계획내가 기대하는 변화
    CPU 구성4×Cortex-A76 + 4×Cortex-A55, 8코어8×Cortex-A730 + 4×Cortex-A530, 12코어전체 코어 1.5배, 큰 코어 2배로 병렬 작업 여유
    CPU 정수 처리량자료의 참고값 93K DMIPS300K DMIPS 이상참고값 대비 약 3.2배 규모의 처리량
    NPU6 TOPS(INT8)RKNN-P3, 32 TOPS 이상명목 최고 연산량 약 5.3배, 실제 모델에서의 가속 기대
    GPUMali-G610 MC4Mali-Magni, 2.0 TFLOPS 이상그래픽과 GPU 연산의 여유 증가 기대
    메모리내 보드 8GB LPDDR4xLPDDR5/5x/6, 최대 200GB/s 계획큰 모델 적재와 데이터 이동의 숨통이 트이길 기대

    CPU는 코어 수뿐 아니라 세대도 크게 바뀐다. 내가 조사한 RK3588의 93K DMIPS와 RK3688 계획의 300K DMIPS를 놓으면 약 3.2배다. 나는 이 차이가 CPU가 맡는 전후처리와 여러 작업을 동시에 돌릴 때 특히 반가울 것으로 본다. 단일 스레드 속도나 VAE 시간이 같은 배수로 바뀌는지는 실제 작업에서 따로 살펴볼 부분이다.

    NPU의 6→32 TOPS는 약 5.3배다. 숫자만 보면 가장 기대되는 부분이지만, 내가 쓰는 Anima는 FP16 DiT와 CPU 처리가 섞여 있다. 그래서 아래 시간 전망에서는 INT8 TOPS 배수를 그대로 쓰는 대신, 데이터 이동과 CPU 처리를 포함한 디노이징 단계 전체가 얼마나 빨라질지를 따로 가정했다. GPU는 세대 변화와 2.0 TFLOPS 이상이라는 목표를 보고 기대하고 있다.

    메모리도 내게는 중요한 업그레이드 이유다. 지금의 8GB LPDDR4x 환경에서 더 빠른 메모리와 넉넉한 용량을 갖춘 보드로 넘어간다면 모델 적재와 반복 실행이 한결 편해질 것으로 기대한다. 최대 200GB/s는 조사 자료의 칩 계획값이므로, 구입할 보드의 실제 메모리 구성도 유심히 볼 생각이다.

    지금 보드에서 쌓인 실제 사용 기록

    비교의 출발점은 내가 운용했던 ROCK 5C 8GB다. 새 보드를 기다리는 동안 기존 환경이 어디에서 시간을 쓰고 얼마나 뜨거워졌는지부터 다시 살펴봤다.

    내가 사용한 보드는 Radxa 공식 ROCK 5C 문서의 표준판인 RK3588S2 모델이며 메모리는 8GB다. 소프트웨어에서는 런타임 타깃을 rk3588로 지정한다. Lite 모델에는 RK3582가 들어가므로 보드 이름과 칩 이름을 함께 적어 두었다.

    실측에 사용한 작업은 앞서 ROCK 5C 8GB의 RKNN 변환과 실행 결과에서 다룬 512×512 Anima 이미지 생성이다. NPU와 CPU가 다음처럼 일을 나눠 처리한다.

    파이프라인 단계처리 장치역할
    텍스트 인코딩CPU프롬프트 컨텍스트 생성
    DiT attention·FFNNPU분할한 FP16 RKNN 그래프 실행
    정규화·게이트·잔차 처리CPU호스트 연산과 FP32 잔차 누적
    VAE 디코딩CPU잠재 표현을 최종 이미지로 복원

    2026년 8월 13일부터 8월 25일까지 수집된 원본 작업 로그를 전수 재집계한 결과, 총 649회의 생성 작업 시도 중 정상 완료 404건, 작업 실패 245건으로 집계되었다. 정상 완료된 404건 작업의 세부 소요 시간 분포는 다음과 같다.

    • 평균 소요 시간: 1658.52초 (약 27.64분)
    • 중앙값: 1627.29초 (약 27.12분)
    • 최소 소요 시간: 1513.56초 (약 25.23분)
    • 최대 소요 시간: 1911.67초 (약 31.86분)
    • 95백분위수 (p95): 1799.59초 (약 29.99분)

    완료한 404건 중 30분을 넘긴 작업은 20건, 약 4.95%였다. 여러 스텝 설정을 번갈아 쓰던 시기의 기록이라, 내게 한 장 평균 27.64분은 당시 사용 속도를 떠올리게 하는 숫자다. RK3688에서는 같은 스텝 조건을 맞췄을 때 대기 시간이 얼마나 줄어들지 보고 싶다. 245건의 실패 시도도 함께 남아 있어, 새 장비에서는 완료 시간과 실패 양상을 같이 살펴볼 생각이다.

    센서 7002개로 본 온도와 NPU 클럭

    속도와 함께 다시 본 것은 온도다. 2026년 8월 20일부터 8월 25일까지 약 1분 간격으로 쌓인 센서 샘플 7002개를 모아 보니, 보드 각 부위의 온도 변화가 꽤 선명하게 보였다.

    7002개 센서 샘플 전체에서 확인된 온도 센서 존별 주요 통계는 다음과 같다.

    센서 존 (Zone) 평균 온도 (°C) 중앙값 (°C) 95백분위수 (°C) 관측 최고 온도 (°C)
    bigcore0-thermal 40.22 39.77 59.15 75.77
    bigcore1-thermal 40.37 39.77 59.15 75.77
    littlecore-thermal 39.72 38.85 56.38 70.23
    soc-thermal 39.19 38.85 54.54 69.31
    npu-thermal 38.21 37.92 51.77 64.69
    center-thermal 38.00 37.92 50.85 63.77
    gpu-thermal 37.35 37.00 49.00 61.00

    측정 환경: 실내 운용 로그의 온보드 센서값. 당시 주위 온도와 방열판·팬의 세부 설정은 미기록.

    내가 좋게 본 부분은 NPU 클럭이다. 수집한 7002개 샘플에서는 rknpu_ondemand 환경의 주파수가 1,000,000,000 Hz, 즉 1.0 GHz로 유지됐다. 센서별 최고 온도는 각각의 시점에 기록된 값이다. 새 장비에서는 이 기록에 코어별 부하도 더해, 추론이 돌아가는 모습을 좀 더 자세히 보고 싶다.

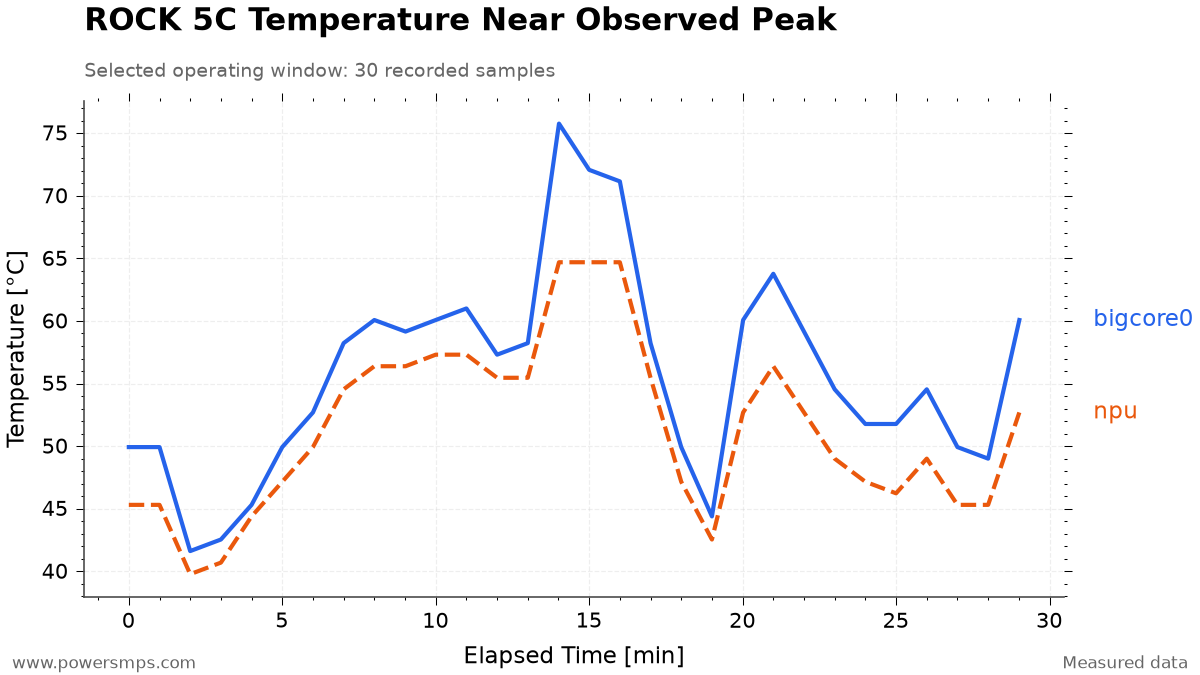
    온도 변화는 그래프로 보는 편이 더 와닿는다. 아래는 bigcore0가 최고 75.769°C를 기록한 시점의 전후 15분에서 고른 30개 샘플이다.

    ROCK 5C 최고 CPU 센서 온도 주변 30개 샘플: CPU는 파란 실선, NPU는 주황 점선
    ROCK 5C 운용 중 CPU 센서 최고점 주변의 30개 샘플. 파란 실선은 CPU bigcore0, 주황 점선은 NPU 온도다.

    bigcore0 온도는 50°C 안팎을 유지하다가 14분 시점에 최고 75.769°C까지 상승한 후, 18분 시점에 49.923°C로 하강하는 동적 특성을 보였다. 동일 구간에서 NPU 온도는 14분부터 16분 사이에 걸쳐 최고 64.692°C를 유지한 뒤 점진적으로 냉각되었다.

    내 눈에는 온도가 한 수준에 머무르기보다 작업 흐름을 따라 오르내리는 모습이 먼저 들어온다. RK3688에서도 이 곡선이 어떻게 달라질지 궁금하다. 더 짧아진 대기 시간과 함께, 방열판이나 팬을 어느 정도로 준비하면 편하게 쓸 수 있을지도 직접 확인해 보고 싶다.

    단일 MatMul과 전체 추론 성능의 차이

    Radxa ROCK 5C(RK3588 런타임 타깃, RKNPU 드라이버 0.9.8, RKNN Runtime 2.3.2) 환경에서 Anima DiT FFN 블록의 주요 형상(Linear 1: M=1024, K=2048, N=8192 / Linear 2: M=1024, K=8192, N=2048, 각 34.36 GOP)을 대상으로 RKNN MatMul C API 단일 코어 벤치마크를 수행한 결과는 다음과 같다.

    연산 경로 및 정밀도 Linear 1 지연 시간 Linear 2 지연 시간 두 연산 합계 FP16 대비 배속
    FP16 x FP16 -> FP16 51.89 ms 460.61 ms 512.50 ms 1.00x
    INT8 x INT8 -> INT8 19.13 ms 115.67 ms 134.80 ms 3.80x
    FP16 x FP16 -> FP32 57.93 ms 463.10 ms 521.03 ms 1.00x
    INT8 x INT8 -> INT32 100.80 ms 118.32 ms 219.12 ms 2.38x

    이 표에서 내가 눈여겨본 것은 두 번째 Linear다. 두 연산이 각각 34.36 GOP인데도 차원을 줄이는 Linear 2의 FP16 실행에는 460.61 ms가 걸렸다. INT8 입출력 경로의 합계는 FP16보다 약 3.80배, INT32 출력 경로의 비교에서는 약 2.38배 빨랐다. 같은 보드에서도 연산 형상과 정밀도에 따라 체감 속도가 크게 달라질 수 있다는 점이 흥미로웠다.

    당시 실험에서는 W8A16 형식인 RKNN_FLOAT16_MM_INT8_TO_FLOAT32와 RKNN_FLOAT16_MM_INT8_TO_FLOAT16의 context 생성이 거부됐다. MatMul API에 core_mask=7을 요청했을 때는 단일 코어 auto fallback으로 실행됐고, INT8 실행에는 failed to update out cvt offset! 경고도 남았다. 이런 경험 때문에 새 보드에서도 지원 정밀도와 실제 코어 설정을 먼저 살펴볼 생각이다.

    속도보다 더 신경 쓰였던 것은 결과물이었다. W8A8 화질 실패와 8GB 상주 실험에서 FFN Linear W8A8을 적용한 이미지는 육안으로 봤을 때 만족스럽지 않아 FP16 구성으로 돌아갔다. RKNN Toolkit 2.3.2와 2.3.0 비교에서도 툴체인에 따른 차이를 경험했다. 그래서 RK3688에서 내가 가장 궁금한 것은 TOPS 숫자 자체보다, 지금 쓰는 모델의 화질을 유지하면서 얼마나 빨라질 수 있느냐다.

    RK3688 구입 후 반복할 다섯 가지 시험

    장비를 구입하면 아래 다섯 가지를 두 보드에서 차례로 돌려 볼 생각이다. 같은 조건에서의 비교와 각 보드에 맞춘 최적화를 함께 해 보면, 실제로 쓰기 좋은 구성이 더 잘 보일 것 같다.

    모델과 입력, 정밀도, 해상도, 스텝수와 시드는 먼저 맞춰 둔다. 보드·메모리·SDK 버전과 냉각 환경도 함께 적어 두면 나중에 결과를 다시 보기 편하다.

    해 볼 작업내가 보고 싶은 것
    유휴 상태아무 작업이 없을 때의 온도와 클럭, 계측기를 준비한 뒤의 대기 전력
    CPU 전체 코어 부하같은 스레드 수의 처리량 비교와 각 보드 전체 코어 부하를 나눠 보고, 유지 클럭과 온도를 함께 기록
    NPU 단일 연산같은 형상·정밀도에서 실행 시간과 출력 차이, 실제 수락된 코어 설정 확인
    Anima 전체 추론모델 로드·인코딩·디노이징·VAE를 포함한 대기 시간, cold와 warm 실행 비교
    장시간 반복 운용완료·실패 횟수, p50/p95 시간, 메모리·스왑과 온도·클럭의 변화

    전력계를 준비하면 작업 중 소비전력도 시간에 따라 기록해 이미지 한 장에 든 에너지를 계산해 보고 싶다. 실행 파일의 해시는 보드별로 남기고, 원본 모델과 입력을 맞춰 비교할 계획이다.

    Spectrum 최적화 기법처럼 보드에 맞춘 최적화는 따로 정리하려고 한다. 기본 조건에서의 차이와 실제로 가장 편하게 쓸 구성을 함께 보고 싶기 때문이다.

    내가 기대하는 RK3688

    25.20분 걸린 작업이 새 보드에서는 몇 분일까

    여러 설정을 섞어 돌린 평균과 별도로, 단계별 시간이 남아 있는 Spectrum 20스텝 실험을 꺼냈다. 512×512, CFG 4.0, 시드 20260812 조건에서 FP16 DiT에 Spectrum을 적용하고 CPU VAE로 마무리했을 때, 디노이징은 1356.58초, VAE는 155.46초였다. 두 단계를 합하면 1512.04초, 약 25.20분이다. 아래 시간의 범위는 이 두 단계이며 프롬프트 인코딩과 모델 로드는 제외했다.

    나는 이 25.20분이 RK3688에서 대략 7~13분으로 줄어들 수 있을지 기대하고 있다. 중심으로 잡은 예상은 9분 안팎이다. 디노이징 단계와 CPU VAE의 가속 폭을 다르게 놓고 계산하면 다음과 같다.

    시나리오디노이징 단계 가정CPU VAE 가정두 단계 합계
    현재 ROCK 5C 실측1356.58초155.46초25.20분
    조심스러운 기대2배 빨라짐1.5배 빨라짐13.03분 예상
    내가 기대하는 중간3배 빨라짐2배 빨라짐8.83분 예상
    잘 맞아떨어지는 경우4배 빨라짐2.5배 빨라짐6.69분 예상

    계산은 1356.58초 ÷ 디노이징 가속 배수 + 155.46초 ÷ VAE 가속 배수다. 예를 들어 디노이징 전체가 3배, CPU VAE가 2배 빨라지면 약 8.83분이 된다. 이 배수는 새 CPU·NPU·메모리 구성을 보고 내가 잡은 시나리오다. 특히 FP16 연산 지원과 RKNN 툴체인이 잘 맞아야 낙관적인 쪽에 가까워질 것으로 본다.

    구입 후에는 같은 20스텝 설정으로 디노이징과 VAE 시간을 다시 기록해 이 예상표 옆에 붙일 생각이다. 나는 한 장에 9분 안팎까지 내려오기만 해도 프롬프트를 고쳐 가며 이미지를 만드는 흐름이 꽤 달라질 것 같다. 온도와 팬 소음까지 함께 좋아진다면 업그레이드 만족도는 더 높을 것이다.

    나는 RK3688이 긴 이미지 생성의 대기 시간과 메모리 부담을 얼마나 덜어 줄지 기대하고 있다. 최고 성능뿐 아니라 온도와 소음, 반복 실행의 편안함까지 좋아진다면 업그레이드할 이유가 더 분명해질 것이다.

    구입한 뒤에는 이 글에 처리 시간·화질·메모리·온도 결과를 차근차근 추가할 생각이다. 지금의 예상이 실제 사용에서도 맞아떨어지는지 확인하고, 세부 설정과 시행착오는 후속 글로 이어 가려고 한다.

  • 평활콘덴서 수명 계산: 고온 PCBA의 온도 측정과 배치, 벤트 이격거리

    평활콘덴서 수명 계산: 고온 PCBA의 온도 측정과 배치, 벤트 이격거리

    평활콘덴서 수명은 데이터시트의 시간 수치만으로 판단하기 어렵다. 고온에서 동작하는 PCBA를 검토할 때 직접 중요하게 확인하는 기준은 실제 고온 조건에서 측정했는지, 그 온도가 제조사 수명식의 어느 입력에 해당하는지다. 실온에서 보드를 개방한 채 얻은 값을 실제 제품의 고온 사용조건에 그대로 적용해서는 안 된다.

    온도는 열전대로 실측하고, 브릿지 다이오드·SMPS 전력소자·트랜스와 히트싱크의 열 흐름을 함께 살펴본다. 수명 계산과 별도로 벤트가 열렸을 때 다른 부품이나 섀시와 쇼트될 가능성도 검토한다. 이 글은 이러한 설계 경험을 바탕으로, 액체 전해질을 사용하는 비고체 알루미늄 전해 평활 콘덴서의 수명 평가 순서를 설명한다.

    평활콘덴서 수명 계산은 데이터시트의 시험 조건부터 확인한다

    알루미늄 전해콘덴서는 사용 중 전해질이 실링을 통해 서서히 손실되면서 정전용량이 감소하고 손실이 커질 수 있다. 일반적인 평활 회로에서는 주변온도와 리플 전류에 의한 자기발열이 수명 평가의 중요한 인자다. 먼저 채택한 시리즈의 Endurance 조건에서 온도·인가 전압·리플 중첩 여부와 수명 판정 기준을 확인해야 한다. Nippon Chemi-Con 수명 기술자료

    온도에 따른 영향을 설명하는 실무 근사식은 다음과 같다. 단, 이 식만으로 리플 조건까지 모두 반영한 최종 제품 수명이 계산되는 것은 아니다.

    \[L_x=L_o\times B_t^{(T_o-T_x)/10}\]

    여기서 \(L_o\)는 데이터시트 시험 조건에서의 규정 수명, \(L_x\)는 사용조건에서의 추정 수명이다. \(T_o\)는 카테고리 상한 온도, \(T_x\)는 해당 제조사 모델에서 정의한 실제 주변온도이며, \(B_t\)는 온도 가속계수다. 리플 자기발열 보정과 적용 한계는 제품별 수명식 또는 계산 도구로 확인한다.

    흔히 말하는 ‘온도가 10°C 낮아지면 수명이 약 2배’는 \(B_t=2\)를 가정한 근사다. Nippon Chemi-Con은 대략 60~95°C의 주변온도 구간에서 이 근사를 설명하며, 최대 사용온도가 105°C 이상인 제품 등에서는 추정 온도 범위에 따라 계수 보정이 필요할 수 있다고 안내한다. 모든 시리즈와 온도 범위에 같은 계수를 적용하거나 계산 결과를 보증수명으로 해석해서는 안 된다.

    정전용량·정격전압·허용 리플 전류의 기본 선정은 기존 글 평활 커패시터의 선택 방법과 함께 검토하면 좋다.

    고온 PCBA에서 측정해야 하는 세 가지 온도

    고온에서 사용하는 PCBA라면 실제 사용조건을 재현해 측정하는 것이 기본 원칙이다. 실제 섀시와 커버, 설치 방향, 냉각 조건을 유지하고 예상 입력·출력·부하 조건을 기록한다. 연속 운전 제품은 온도가 충분히 안정된 상태에서 판단한다. 최대 부하라는 이유만으로 모든 부품의 가장 가혹한 온도 조건이 확인됐다고 가정하지 않고, 제품의 사용범위에 맞게 측정조건을 정한다.

    수명식에 넣기 전에는 다음 세 가지 온도를 구분해야 한다. 아래 주변온도 설명은 Nippon Chemi-Con의 측정 정의를 기준으로 하며, 실제 적용 시 채택한 제조사의 정의를 확인한다.

    구분 의미 수명 평가에서 주의할 점
    주변온도 해당 실장 위치에서 외부 대류·복사·전도의 영향을 받되 콘덴서 자기발열은 제외한 온도 실내 공기 온도와 같다고 볼 수 없음
    케이스 표면온도 동작 중 콘덴서 외벽에서 측정한 온도 주변 열영향과 자기발열이 반영되므로 주변온도로 그대로 치환하지 않음
    코어온도 콘덴서 내부 소자의 온도 표면온도와 같다고 단정하지 않고 제조사 방법으로 평가

    리플 전류에 의한 손실은 다음과 같이 근사할 수 있다. 이 손실에 따른 내부 온도 상승이 수명에 영향을 주므로, 주변온도만 낮다고 판단해서는 안 된다.

    \[P\approx I_{\mathrm{rms}}^2\times\mathrm{ESR}\]

    동작 중 표면온도를 주변온도 입력란에 넣고 리플 자기발열을 다시 더하면 중복 반영이 될 수 있다. 반대로 표면온도만 보고 내부온도 평가를 생략해서도 안 된다. 측정값이 주변·표면·코어 중 무엇인지 기록한 뒤 제조사 모델의 입력 정의와 맞추는 것이 먼저다.

    열전대로 측정할 때는 접촉과 사용조건 재현이 중요하다

    수명 평가에 사용할 온도를 열전대(Thermocouple)로 직접 실측하는 것은 매우 중요하다. 다만 열전대라는 이유만으로 측정값이 항상 정확해지는 것은 아니다. 센서의 접촉과 고정, 계측기 상태, 전기적 절연 조건을 확인해야 한다. 부착 위치와 측정조건을 함께 남겨야 배치 변경 전후도 같은 기준으로 비교할 수 있다.

    Nippon Chemi-Con은 열화상으로 열영향이 큰 위치를 찾고, 자기발열을 제외한 외부 열영향을 평가하기 위해 더미 콘덴서와 여러 열전대를 사용하는 방법을 소개한다. 핵심은 동작 중인 캔 표면값을 곧바로 주변온도라고 부르지 않는 것이다. 상세한 전문 측정 절차는 제조사의 주변온도 측정 안내를 따른다.

    측정선을 연결하기 위해 커버를 열거나 팬과 덕트 조건을 바꾸면 실제 열환경과 달라질 수 있다. 센서를 설치한 뒤에도 최종 조립 상태와 냉각 조건을 재현하고, 온도가 안정되는지 확인해야 한다. 측정 위치는 제조사 방법에 맞추고, 대기 시간은 제품이 열평형에 도달하는지를 기준으로 정한다.

    센서 부착과 위치 변경은 전원을 차단하고 잔류 전압이 방전됐는지 확인한 뒤 수행한다. 전원부 측정에서는 센서뿐 아니라 계측기와 연결을 포함한 절연 조건을 검토해야 한다. 콘덴서를 개조하거나 충전된 단자에 접촉하는 방식으로 내부온도를 측정해서는 안 된다.

    브릿지 다이오드와 히트싱크의 대류를 고려해 배치한다

    평활콘덴서 주변에는 브릿지 다이오드, SMPS 전력소자, TRANS(트랜스포머) 같은 발열 부품이 함께 놓인다. 경험상 부품 사이 거리만 확인하는 것으로는 부족하다. 발열 부품 자체와 부착 히트싱크에서 나온 열이 어떤 경로로 콘덴서에 도달하는지 함께 봐야 한다.

    자연 대류와 강제냉각에서는 열 흐름이 달라질 수 있고, 제품 설치 방향도 영향을 준다. 히트싱크가 방출한 고온 공기의 경로에 콘덴서가 놓이지 않는지 실제 장착 상태를 기준으로 검토한다. 배치 변경 후에는 같은 사용조건에서 다시 측정해 열영향이 줄었는지 확인하는 방식으로 판단한다.

    대류뿐 아니라 복사와 기판을 통한 열전도도 고려한다. Nichicon은 전해콘덴서 가까이 또는 기판 반대면의 콘덴서 아래에 발열 부품을 배치하지 않도록 안내한다. 배치 공간이 제한될수록 주변 열원과 냉각 경로를 함께 검토해야 한다. Nichicon 적용 가이드라인

    벤트 이격거리: 작동 여유와 2차 쇼트 방지는 별도로 검토한다

    내부 전해액의 기화나 가스 발생 등에 의해 압력이 상승하는 고장 상황을 고려해야 한다. 압력 벤트(Pressure Vent)는 내부 압력 증가에 따른 파열 위험을 줄이기 위한 기구다. 실무에서는 벤트가 열렸을 때 변형된 부분이 인접 부품이나 섀시에 닿는지, 전해액이 도체 사이에 도달해 쇼트될 가능성이 있는지를 함께 검토한다.

    Nippon Chemi-Con이 제시하는 벤트 상부 최소 여유의 예시는 아래와 같다. 개별 제품의 사양과 예외 조건을 우선 확인해야 한다. 이 치수는 벤트 작동을 방해하지 않기 위한 기계적 여유이며, 전기적 절연이나 전해액 분출에 대한 안전을 보장하는 거리가 아니다. 압력 벤트와 상부 공간 안내

    케이스 외경 벤트 상부 최소 여유 예시
    8 mm(일부 6.3 mm 제품)~16 mm 2 mm 이상
    18~35 mm 3 mm 이상
    40 mm 이상 5 mm 이상

    Nichicon은 벤트 위에 회로 패턴이나 배선을 두지 않도록 안내하며, 전해액은 전도성이 있어 PCB에 닿으면 패턴 부식이나 단락으로 발연·발화 위험이 있다고 설명한다. 따라서 상부 공간의 숫자만 확인한 뒤 검토를 끝내지 말고, 실제 벤트 방향과 분출 예상 경로도 살펴야 한다.

    최종 배치에서는 벤트의 개방 방향과 변형 범위, 부품·섀시의 위치와 조립 공차, 전해액이 도달할 경로, 동작전압과 완제품 안전요구를 함께 검토한다. 전기적 공간거리·연면거리와 벤트 작동공간은 별도의 항목이다. 모든 구조에 통용되는 안전 이격거리 하나를 정할 수는 없으므로, 부품 제조사 자료와 제품 구조에 맞춰 최종 거리를 결정해야 한다.

    수명 말기의 건조화와 압력 상승에 따른 벤트 동작도 구별해야 한다. 전해액 손실로 정전용량이 감소하고 손실이 커지는 열화가 모두 벤트 개방으로 끝나는 것은 아니다. 수명 계산은 열화를 평가하고, 배치 검토는 벤트 작동 같은 고장 상황에서 2차 사고를 줄이는 역할을 한다.

    온도 감소에 따른 상대수명비 비교

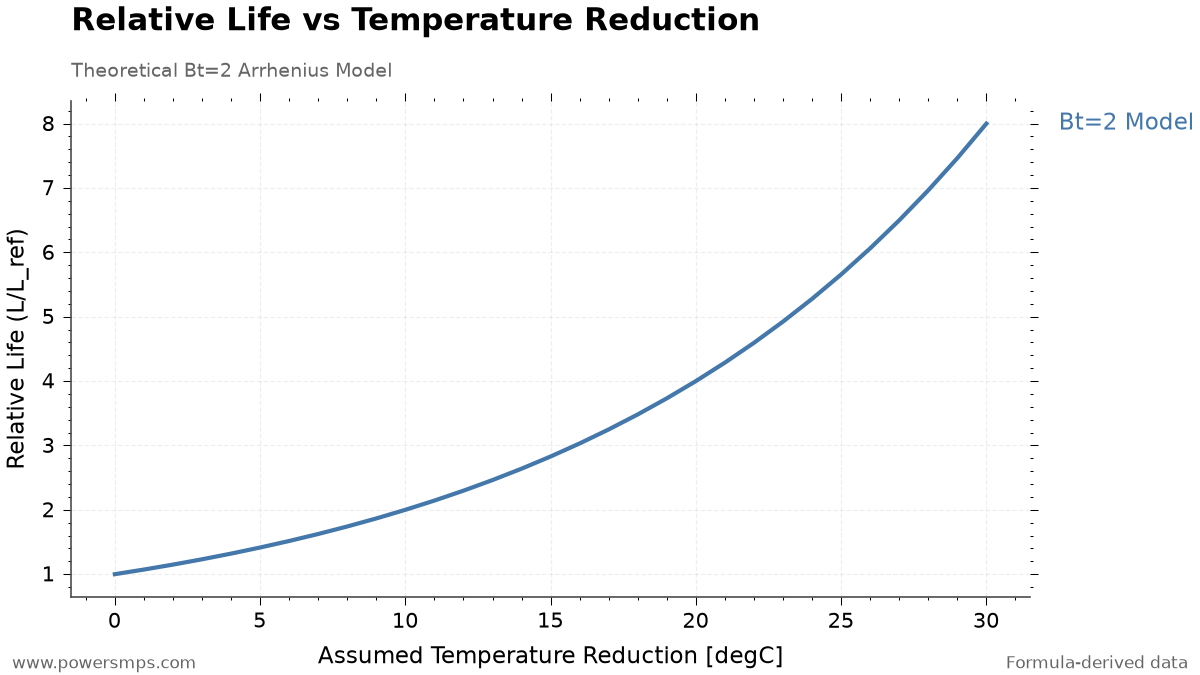
    아래는 \(B_t=2\)이고 나머지 조건이 같다고 가정한 교육용 계산이다. 실제 측정 결과나 특정 제품의 보증수명이 아니다. 기준 대비 온도 감소량에 따라 다음 상대수명비를 계산했다. 실제 적용 가능 온도 범위와 리플 보정은 제품별로 확인해야 한다.

    \[\frac{L}{L_{\mathrm{ref}}}=2^{\Delta T_{\mathrm{red}}/10}\]
    가정한 온도 감소량 계산된 상대수명비
    0°C 1배
    10°C 2배
    20°C 4배
    30°C 8배
    Bt=2 가정에 따른 온도 감소량별 상대수명비. 교육용 계산이며 실측 또는 특정 제품의 보증수명이 아닙니다.
    Bt=2 가정에 따른 온도 감소량별 상대수명비. 교육용 계산이며 실측 또는 특정 제품의 보증수명이 아닙니다.

    이 비교는 열전대로 사용조건의 온도를 확인하고 발열원 배치를 검토하는 이유를 보여준다. 실제 설계에서는 온도만 낮췄다는 이유로 이 배수를 바로 제품 수명에 적용하지 않고, 해당 시리즈의 수명 모델로 다시 평가한다.

    검토를 마칠 때에는 다음 항목을 확인한다.

    • 고온 사용조건과 실제 섀시·설치 방향·냉각 조건을 재현했는가?
    • 열전대의 접촉·고정·계측기 상태·절연을 확인했는가?
    • 주변·표면·코어온도를 구분하고 자기발열을 중복 반영하지 않았는가?
    • 제조사 시리즈의 Endurance 조건과 수명식 적용 범위를 확인했는가?
    • 브릿지 다이오드·트랜스·SMPS 전력소자와 히트싱크의 열 흐름을 고려했는가?
    • 벤트 작동공간과 부품·섀시 쇼트 방지 공간을 각각 검토했는가?
  • Hindsight 운영 비용: 임베딩은 API, 리랭커는 로컬을 선택한 이유

    Hindsight 운영 비용: 임베딩은 API, 리랭커는 로컬을 선택한 이유

    Hindsight를 Docker로 운영하면서 LLM과 임베딩은 API를 쓰고, 리랭커는 로컬 NPU에서 실행하고 있다. 임베딩 API 비용은 낮아 로컬 운영의 필요성을 느끼지 않았고, 리랭커는 API 비용 부담 때문에 로컬을 선택했다.

    Docker 기반 장기 기억 관리 시스템인 Hindsight를 단일보드 컴퓨터(ROCK 5C, RK3588 SoC, 8GB RAM) 환경에서 운영하면서, 워크로드의 특성에 따라 클라우드 API와 로컬 NPU를 분리하는 하이브리드 아키텍처를 적용했다. LLM과 임베딩은 상용 API로 처리하고, 검색 단계의 후보 재순위화(Reranking)는 로컬 NPU로 처리하도록 구성했다.

    9개 완전한 UTC 날짜 동안 게이트웨이에 기록된 12,536건의 실측 트래픽과 하드웨어 벤치마크 데이터를 바탕으로, 이러한 분리 설계를 채택한 경제적·기술적 배경과 지연시간 트레이드오프를 정리한다.


    1. 하이브리드 아키텍처: LLM·임베딩 API와 로컬 NPU 리랭커의 분리 구성

    Hindsight 환경에서 각 추론 작업을 분배한 기준은 자원 요구량과 API 과금 구조의 상호작용이다.

    • 생성형 LLM: OpenCode Go를 통한 DeepSeek V4.1 Flash 클라우드 API를 사용한다. 월 구독 기반의 사용 한도 내에서 피크 시간대(입력 100만 토큰당 \(0.30, 출력\)1.20, 캐시 읽기 $0.006)와 비피크 시간대(50% 할인 적용) 요율로 계측된다.
    • 텍스트 임베딩: Google Gemini Embedding 2(768차원) 클라우드 API를 사용한다.
    • 문서 리랭커: 단일보드 하드웨어의 로컬 NPU(Rockchip RK3588, RKLLM 1.2.1)를 활용하여 Qwen3-Reranker-0.6B를 구동한다.

    같은 보드에서의 모델 실행과 메모리 제약은 Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험와 RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과에서도 살펴봤다.

    Hindsight와 상류 모델 간의 통신은 중앙 LLM 게이트웨이인 Bifrost(v2.2.4)를 통해 중계된다. 리랭커의 경우 상용 클라우드 API를 지속적으로 호출할 때 누적되는 단가 부담을 피하기 위해, Alibaba Cloud Qwen 팀이 공개한 Qwen3-Reranker-0.6B 모델을 커뮤니티(Hugging Face dulimov)에서 배포한 RK3588 전용 W8A8 양자화 형식(.rkllm)으로 변환된 산출물을 사용했다. 이 모델을 Docker Compose 격리 컨테이너에서 C++ 네이티브 로짓 브릿지(RKLLM_INFER_GET_LOGITS) 기반의 Cohere 호환 HTTP 서비스로 래핑하여 연결했다.


    2. Bifrost 기록: 9일간의 요청과 비용 범위

    Bifrost의 Hindsight 전용 가상 키 로그에서 2026년 10월 14일 00:00:00Z부터 2026년 10월 23일 00:00:00Z까지 9개 UTC 날짜를 조회했다. 아래 표는 이 범위에서 Gemini Embedding 2와 현행 DeepSeek V4.1 Flash의 성공 요청만 정리한 것이다.

    프로바이더 및 모델 처리 성공 요청 수 프롬프트 토큰 완료 토큰 총 토큰 Bifrost 기록액 (USD)
    gemini / gemini-embedding-2 9,484건 1,307,222 0 1,307,222 $0.2614
    opencode-go / deepseek-v4.1-flash 889건 6,833,856 2,754,646 9,588,502 $2.5412

    두 금액은 게이트웨이에 설정한 단가로 계산한 기록액이다. Gemini도 실제 청구는 계정의 무료 사용 구간 등에 따라 달라질 수 있다.

    첫째, OpenCode Go의 DeepSeek V4.1 Flash에 표기된 계측 금액($2.5412)은 서비스 사업자의 시간대별 요율표(피크 및 50% 비피크 할인)에 따라 게이트웨이가 토큰 사용 한도 관리를 위해 계산한 환산액이다. 이는 운영자의 실제 월 구독료 청구서 금액을 나타내는 것이 아니다.

    둘째, Gemini 임베딩은 토큰과 비용 기록을 보완한 뒤의 로그를 사용했다. 이전에 누락된 기록을 무료 사용으로 계산하지 않았다.

    셋째, 같은 관측 범위에서 로컬 Qwen 리랭커의 성공 요청은 731건이었다. 이 구성은 리랭킹을 위해 외부 종량제 API를 호출하지 않는다. 리랭커의 토큰 집계 누락을 토큰 사용량이 0이라는 뜻으로 해석하지 않았다.

    전체 12,536건에는 초기 환경 구성, 부하 시험, 재시도, 백그라운드 작업과 과거 경유 경로도 포함돼 있다. 비용 기록이 빠진 경로까지 합쳐 전체 운영비를 계산하지 않았으며, 이 표를 일평균·월평균 또는 기억 저장·회상 한 건의 비용으로 외삽하지 않았다.


    3. 임베딩을 클라우드 API로 유지한 이유: 130만 토큰에 0.26달러

    Google의 공식 요금 정책에 따르면 Gemini Embedding 2의 텍스트 표준 유료 단가는 입력 100만 토큰당 \(0.20이다(비동기 Batch API는\)0.10이나, Hindsight의 동기식 파이프라인은 표준 요율이 적용된다).

    9개 UTC일 동안 Hindsight가 기억 저장과 쿼리 처리를 위해 소비한 Gemini 프롬프트 토큰은 총 1,307,222개였다. 이를 공식 표준 단가로 계산하면 다음과 같다.

    \[1,307,222 \times \frac{\$0.20}{1,000,000} = \$0.2614444\]

    표준 단가로 계산한 값은 $0.2614444다. 표의 $0.2614는 이를 반올림한 표시다. 이 관측 범위에서 9,484건의 임베딩 성공 요청에 대응하는 기록액은 약 0.26달러였다.

    이 사용량에서는 임베딩 API 비용이 낮아 로컬 모델을 추가로 운영할 필요를 느끼지 못했다. 임베딩은 API로 유지하고, 로컬 자원과 운영 작업은 리랭커에 집중하기로 했다. 이는 현재 구성과 사용량에서 내린 판단이다.


    4. 리랭커를 로컬로 내린 이유: Qwen3 RKLLM NPU 성능과 지연시간 실측

    리랭커를 로컬로 옮긴 출발점은 API 비용 부담이었다. 현재 사용 환경에서는 Qwen의 검색 결과 품질에 만족하고 있어 계속 사용하고 있다. 특정 상용 리랭커의 요금과 직접 비교해 절감액을 계산한 것은 아니다.

    로컬 리랭커 환경은 ROCK 5C 단일보드의 RK3588 NPU와 RKLLM 1.2.1 런타임을 사용했다. 커뮤니티에서 배포된 dulimov/Qwen3-Reranker-0.6B-rk3588-1.2.1 W8A8 양자화 모델을 올리고, C++ 네이티브 브릿지에서 RKLLM_INFER_GET_LOGITS를 호출하여 토크나이저의 yes/no 로짓에 소프트맥스를 적용해 점수를 산출한다. 컨텍스트 길이는 2048 토큰으로 제한하여 초과 시 422 오류를 반환하도록 안전장치를 두었다.

    당시 시험에서 런타임 초기화는 파이썬 모듈 임포트를 제외하고 2.283초, 프로세스 최대 RSS는 1,437,372 KiB(약 1.371 GiB)로 관측됐다. 이 값은 해당 프로세스의 RSS이며 시스템 전체 메모리 사용량과는 다르다.

    품질 검증을 위해 한국어 및 교차언어 질문-문서 쌍으로 구성된 12개의 수제 테스트 케이스를 대상으로 기존 CPU 기반 MiniLM(배치 크기 32)과 순위 정확도를 비교했다. Qwen3 NPU 모델은 12개 중 11개 쿼리에 대해 정답 문서를 1위로 랭킹(정답 1위 비율 11/12, MRR 0.9375)하여, MiniLM의 정답 1위 6개(정답 1위 비율 6/12, MRR 0.6417) 대비 높은 분별력을 보였다(단, 이 12개 테스트 케이스는 파이프라인 통합 점검용 프로브이며 공개 IR 벤치마크 점수를 보증하는 것은 아니다).

    반면 추론 지연시간에서는 NPU 모델의 직렬 연산 구조로 인한 뚜렷한 한계가 확인되었다.

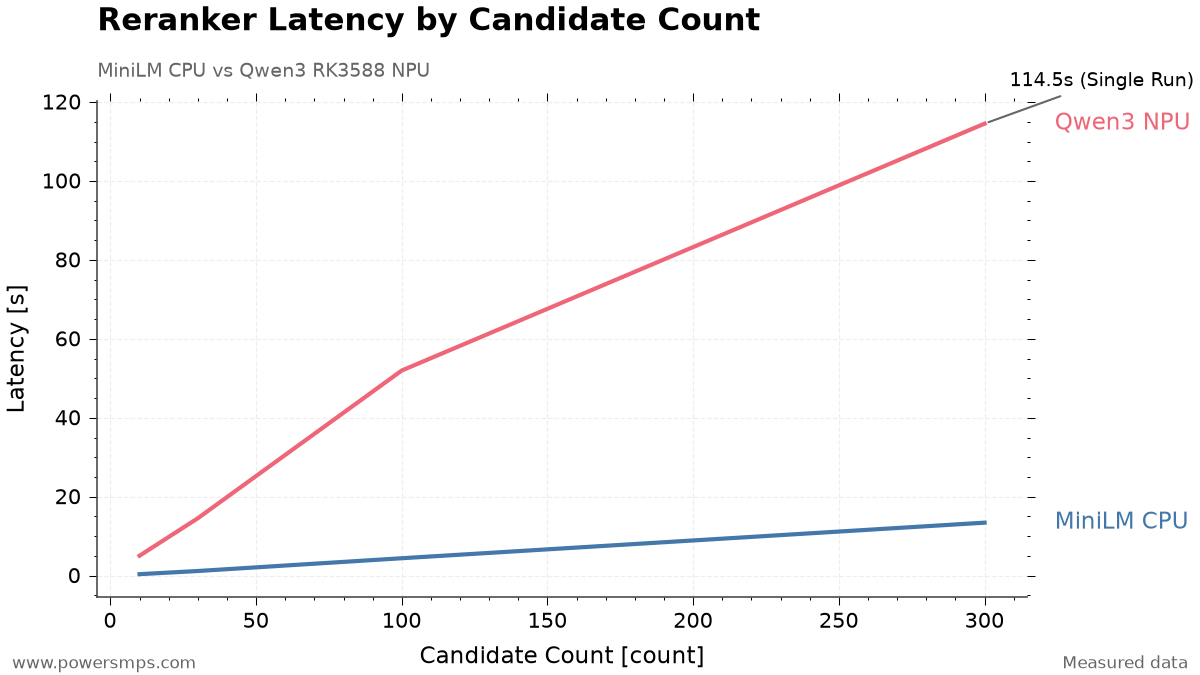
    후보 문서 수 MiniLM CPU (배치 크기 32) Qwen3 RK3588 NPU (단일 직렬 추론)
    10개 0.372초 (3회 중앙값) 5.047초 (3회 중앙값)
    30개 1.175초 (3회 중앙값) 14.544초 (3회 중앙값)
    100개 4.411초 (1회 관측치) 51.980초 (1회 관측치)
    300개 13.423초 (1회 관측치) 114.537초 (1회 관측치)
    Comparison of execution latency across candidate counts between MiniLM CPU (batch size 32) and Qwen3-Reranker-0.6B RK3588 NPU (serial execution). Data for 10 and 30 candidates represent medians of three runs; 100 and 300 candidates are single shared-host observations.
    Comparison of execution latency across candidate counts between MiniLM CPU (batch size 32) and Qwen3-Reranker-0.6B RK3588 NPU (serial execution). Data for 10 and 30 candidates represent medians of three runs; 100 and 300 candidates are single shared-host observations.

    후보 수별 시험은 공유 호스트에서 48개의 짧은 문서를 반복해 구성했다. Qwen의 전체 프롬프트 입력은 평균 약 108토큰이었다. 각 구현의 프롬프트와 토크나이저를 사용했으며, MiniLM은 배치 32로 처리하고 Qwen은 후보를 직렬로 처리했다. 표의 결과는 이 두 구현을 시험한 관측값이다.


    5. NPU 추론이 느려도 로컬 리랭커를 유지하는 실사용 운영 전략

    100개 후보 처리에 52초가 소요되는 지연시간은 실시간 대화형 서비스 관점에서는 매우 긴 대기시간이다. 그럼에도 불구하고 이 구성을 프로덕션에서 유지하고 있는 배경에는 운영자의 실제 워크플로우 특성과 구체적인 최적화 설정이 있다.

    실사용에서 속도 저하가 체감되지 않아 품질이 만족스러운 Qwen을 계속 쓰고 있다. 이는 현재 내 사용 환경에서의 평가다. 앞의 지연시간 측정값이 짧다는 의미로 일반화할 수는 없다.

    시스템 안정성을 유지하기 위해 두 가지 핵심 운영 정책을 적용했다.

    1) 사전 후보군 상한 50개 제한 정책

    초기 설정에서는 최대 300개의 후보 문서를 리랭커로 전달했다. 실제 메모리 회상 시험에서 244개의 후보 문서가 전달되었을 때, 리랭킹에만 181.868초가 소요되어 전체 회상 시간이 183.612초에 달했다.

    이에 Hindsight 설정에 HINDSIGHT_API_RERANKER_MAX_CANDIDATES=50을 적용하여 상호 순위 결합(RRF) 단계에서 상위 50개 후보만 리랭커로 전달하도록 제한했다. 동일 쿼리로 다시 측정한 결과, 리랭킹 처리시간은 104.259초로 42.67% 단축되었고, 전체 메모리 회상 소요시간은 105.791초로 42.38% 단축되었다. 서로 다른 입력과 측정 조건에서 나온 결과이므로 앞의 짧은 문서 시험과 지연시간을 직접 비교할 수는 없다.

    동일 쿼리 단일 실행 비교 이전 설정 (최대 300개 허용, 실 244개 처리) 상한 설정 (사전 상한 50개 적용, 실 50개 처리)
    평가된 후보 문서 수 244개 50개
    리랭킹 처리시간 181.868초 104.259초
    전체 메모리 회상 소요시간 183.612초 105.791초
    최종 반환된 메모리 수 48개 44개
    원본 출처 메모리 순위 1위 1위

    후보 수가 244개에서 50개로 약 5분의 1로 줄었음에도 소요시간이 비례적으로 줄어들지 않은 것은, 프롬프트 캐시 재사용률과 단일보드 공유 호스트의 백그라운드 자원 경합 등 복합적인 요인이 작용한 것으로 추정되며, 후보 수에 따른 선형적 지연시간 확장을 성능 보증으로 간주해서는 안 된다. 후보군을 50개로 캡핑하는 것은 지연시간을 낮추는 대신 잠재적으로 관련 있는 메모리가 리랭킹 대상에서 사전 제외될 수 있는 상충관계를 수반한다.

    2) 게이트웨이 직렬 큐잉과 다단계 타임아웃

    로컬 워커가 한 번에 하나의 요청을 처리하도록 Bifrost의 리랭커 동시성을 1, 채널 버퍼를 10으로 설정했다. 현재 전역 정책에서 버퍼가 가득 차면 추가 요청도 기다릴 수 있으므로, 버퍼 10은 전체 대기 요청의 절대 상한을 뜻하지 않는다.

    실제 합성 부하 시험(16개 문서 요청 1건 및 2개 문서 요청 10건 연속 유입)을 수행한 결과, 11건의 요청 모두 33.2~35.1초 범위 내에서 HTTP 200으로 정상 처리되었으며, NPU 워커 프로세스가 재시작 없이 안정적으로 재사용되었다.

    또한 예기치 않은 NPU 정체를 방지하기 위해 다단계 타임아웃 마진을 구성했다.

    • Hindsight 리랭커 타임아웃: 1800초 (30분)
    • Bifrost 업스트림 소켓 타임아웃: 780초
    • 로컬 C++ 네이티브 추론 타임아웃: 600초
    • 네이티브 큐 대기 타임아웃: 120초

    이러한 타임아웃 수치는 시스템의 정상 응답 속도가 아니라, 요청이 대기열에 머물거나 비정상적으로 지연될 때 안전하게 프로세스를 재기동하기 위한 안전 마진이다.


    6. 운영 한계와 의사결정 기준: 단일보드 LLM 시스템의 워크로드 분배

    로컬 리랭커를 유지할지는 API 비용과 결과 품질, 대기시간을 함께 보고 판단해야 한다. 현재 구성을 유지하는 이유와 그 한계는 다음과 같다.

    KURE의 고정 256토큰 FP16 RKNN 모델도 시험했다. 동일한 50개 입력에서 HTTP 리랭크 응답시간은 KURE 10.647초, Qwen 27.798초였다. 다만 KURE에서는 2개 입력의 문서가 잘렸고, 별도 실제 회상 시험에서는 최종 순위도 달라졌다. 이 표본으로 두 모델의 전반적인 품질 우열을 단정할 수는 없다. 현재는 Qwen을 유지하고 있다.

    둘째, 벤치마크 표본의 한계다. 본 운영에서 확인된 정답 1위 11/12(Top-1 적중률) 및 MRR 0.9375의 순위 성능은 서비스 배포를 위한 최소한의 파이프라인 점검용 프로브 결과일 뿐이며, 대규모 한국어 정보 검색(IR) 데이터셋에서의 일반적인 검색 성능을 대변하지 않는다.

    이번 운영에서의 선택 기준은 다음과 같다.

    1. 임베딩: 현재 사용량에서는 API 비용이 낮아 로컬 운영의 필요성을 느끼지 못했다.
    2. 리랭커: API 비용 부담으로 로컬 Qwen을 선택했다. 품질에 만족하고 실사용에서 속도 저하가 체감되지 않아 유지하고 있다.

    현재 사용량에서는 임베딩을 API로 유지할 이유가 충분했고, 리랭커는 비용과 품질을 보고 로컬로 유지할 이유가 있었다. 사용량이나 응답시간 요구가 달라지면 이 선택도 다시 검토할 수 있다.

  • Anima RKNN 추론 최적화: Spectrum으로 생성 시간 41% 단축

    Anima RKNN 추론 최적화: Spectrum으로 생성 시간 41% 단축

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.

    1. 이미지 생성 시간을 줄이려면

    단일 보드 컴퓨터(Single Board Computer, SBC) 환경에서 대규모 확산 변환기(Diffusion Transformer, DiT)를 온디바이스로 구동할 때는 메모리 제약과 연산 시간이 주요 병목이다. Radxa 알리익스프레스 공식 스토어에서 직접 구매한 Radxa ROCK 5C 8GB 보드를 사용해 2026년 8월 환경 기준으로 Anima DiT 추론 최적화 실험을 진행했다.

    512×512 이미지의 20스텝 디노이징에는 2,408.54초가 걸렸다. VAE로 이미지를 복원하는 시간까지 합하면 한 장을 만드는 데 30분을 넘겼다. 계산량을 줄이면서 결과의 화질을 유지할 방법이 필요했다.

    1편에서 실행한 FP16 RKNN 구성에 Spectrum을 적용했다. Euler 스케줄러는 유지하면서 일부 스텝의 모델 계산을 이전 결과에 기반한 예측으로 대체하고, 속도와 화질을 비교했다.

    2. 비교에 사용한 하드웨어와 모델 구성

    실험 하드웨어는 Rockchip RK3588S2 SoC와 8GB 시스템 메모리를 탑재한 Radxa ROCK 5C 단일 보드 컴퓨터다.

    RKNN 런타임 타깃은 rk3588이다. 실험 장비는 ROCK 5C 8GB이며, 같은 상품 페이지의 ROCK 5C Lite와 구분해야 한다.

    Anima의 28개 DiT 블록을 self-attention·cross-attention·FFN으로 나눈 84개 FP16 RKNN 모델을 사용했다. 기본 변환 구조는 1편에서 다룬 구성과 같다.

    NPU는 주요 행렬·어텐션 연산을 처리한다. CPU는 AdaLN과 FP32 잔차 누적, Euler 스케줄러, 텍스트 인코딩과 VAE 디코딩을 담당한다. Spectrum을 추가한 뒤에도 이 역할 분담은 유지했다.

    3. Spectrum은 어떤 계산을 생략하는가

    Spectrum은 Euler를 대체하는 샘플러가 아니다. 이전 계산 결과로 현재 스텝의 denoised 상태를 예측해 모델 재계산을 줄이는 캐싱 기법이다. stable-diffusion.cpp의 Spectrum 구현을 NumPy로 옮겨 Euler 루프에 적용했다.

    Spectrum의 핵심 원리는 확산 과정에서 스텝 간 잠재 변수의 궤적이 급격하게 변화하지 않는 특성을 활용하여, 이전 히스토리 버퍼로부터 denoised 상태인 \(x_0\) 추정치를 예측(forecasting)하는 방식이다.

    각 스텝에서 직접 계산과 예측 중 하나를 선택한다. 두 경로 모두 같은 Euler 스케줄러에 결과를 전달한다.

    • 직접 계산하는 스텝에서는 조건부·무조건부 출력을 CFG로 합성하고, x₀ = xₜ − σ × prediction으로 denoised 상태를 구해 이력에 저장한다.
    • 예측 스텝에서는 이전 이력으로 현재의 x₀를 추정해 NPU 모델 계산을 생략한다.
    • 추정한 x₀는 prediction = (xₜ − x₀) / σ로 흐름 예측값에 되돌린다. 두 경로 모두 같은 Euler 적분기로 다음 상태를 갱신한다.

    이 구조 덕분에 스케줄러 자체는 FlowMatch Euler 방식을 유지하면서도 NPU에 가해지는 텐서 연산 횟수를 줄일 수 있다.

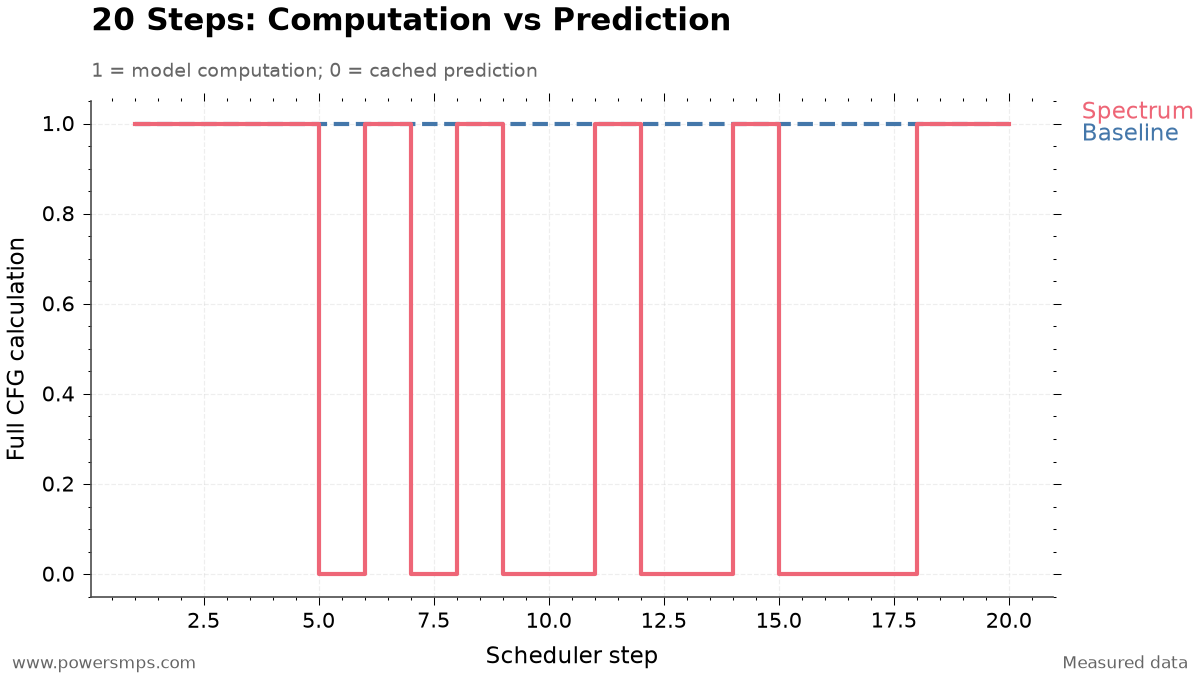
    4. 20스텝 중 11회 계산, 9회 예측

    20스텝 실행에서 직접 계산한 스텝과 예측으로 대체한 스텝은 다음과 같다.

    • 실제 모델 계산 스텝 (11회): Step 1, 2, 3, 4, 6, 8, 11, 14, 18, 19, 20
    • 상태 예측 건너뛰기 스텝 (9회): Step 5, 7, 9, 10, 12, 13, 15, 16, 17

    처음 4개 스텝은 모두 계산해 예측에 필요한 이력을 쌓았다. 중간 구간에서는 9개 스텝을 예측으로 대체했고, 마지막 18~20스텝은 다시 직접 계산했다.

    20-Step Sampling Policy: Baseline vs Spectrum Forecasting
    20-Step Sampling Policy: Baseline vs Spectrum Forecasting

    여기서 계산 스텝 11회는 NPU 실행 11회를 뜻하지 않는다. CFG 한 번에는 조건부·무조건부 입력에 대한 DiT 평가가 각각 필요하다.

    각 transformer 평가는 28개 블록에 배치된 84개의 RKNN 서브그래프를 순회하므로, 1회의 CFG 평가는 168회(84 × 2)의 서브그래프 NPU 실행으로 구성된다. 따라서 Spectrum 파이프라인의 11회 모델 계산은 다음과 같은 실제 하드웨어 순회량을 가진다.

    • 전체 모델 순회(Transformer Pass): 11회 × 2 = 22회
    • 서브그래프 NPU 실행 횟수: 11회 × 2 × 84개 = 1,848회

    반면 기준선 파이프라인은 20스텝 동안 40회의 transformer pass와 3,360회의 서브그래프 NPU 실행을 거친다. 즉, Spectrum은 정확히 18회의 모델 순회와 1,512회의 서브그래프 실행을 건너뜀으로써 하드웨어 부하를 절감했다.

    5. 실측 결과: 전체 생성 시간 41.02% 단축

    기준선과 Spectrum은 같은 ROCK 5C 8GB에서 비교했다. 해상도 512×512, 20스텝, CFG 4.0, 시드 20260812를 동일하게 고정했다.

    평가 항목 기존 비캐시 FP16 RKNN + sd-cpp VAE Spectrum 가속 시험 파이프라인 변화폭 및 배율
    20-step Denoise 시간 2,408.54초 1,356.58초 1,051.96초 단축 (43.68% 감소, 1.775배 가속)
    sd-cpp tiled CPU VAE 디코딩 155.04초 155.46초 +0.42초 (동일 범주의 실행 변동)
    합계 소요 시간 (프롬프트 인코딩 제외) 2,563.58초 1,512.04초 1,051.54초 단축 (41.02% 감소, 1.695배 가속)

    실측 수치가 보여주는 병목과 최적화의 특성은 다음과 같다.

    1. Denoise 연산 가속의 집중: 순수 20스텝 denoise 소요 시간은 기준선 2,408.54초에서 Spectrum 시험 시 1,356.58초로 1,051.96초 감소했다. 이는 43.68%의 시간 단축이자 1.775배의 속도 향상이다. 20스텝 중 9스텝의 연산(45%)을 건너뛴 비율과 거의 일치하는 선형적 가속 효율을 달성했다.
    2. VAE 디코딩의 독립성: ggml 백엔드 기반 ARM NEON/OpenMP로 구동되는 sd-cpp 경량 타일드 CPU VAE 디코더는 기준선 155.04초, Spectrum 파이프라인 155.46초로 0.42초의 차이를 보였다. 이번 비교에서 VAE 시간은 거의 같았으며, 시간 절감은 주로 denoise 구간에서 나타났다.
    3. 전체 파이프라인 가속: 프롬프트 인코딩을 제외한 전체 파이프라인 합계 소요 시간은 기준선 2,563.58초(약 42분 43초)에서 1,512.04초(약 25분 12초)로 1,051.54초 단축되었다. 전체 생성 파이프라인은 41.02% 단축되어 1.695배의 가속을 달성하였으며, 30분 이내 생성을 달성하겠다는 프로젝트 목표를 충족했다.

    6. 빨라진 결과의 화질은 어떤가

    스텝 예측을 수행하는 캐시 알고리즘은 누적 오차로 인해 잠재 공간이 발산하거나 비정상적인 수치(NaN, Inf)를 생성할 위험이 있다. 따라서 파이프라인 완료 직후 생성된 텐서에 대한 수치 검증과 이미지 레벨의 품질 검증을 단계별로 수행했다.

    20스텝을 완료한 최종 잠재 변수에서 NaN과 Inf는 발생하지 않았다. 수치가 발산하지 않는지는 최종 이미지의 화질과 별도로 확인했다.

    512×512 생성 이미지는 이 실험의 육안 화질 기준을 충족했다. 따라서 이번 조건에서는 생성 시간을 줄이면서 허용 가능한 결과를 얻었다.

    본 사용자 육안 판정 결과는 특정 조건(512×512 해상도, 20 스텝, Guidance Scale 4.0, Seed 20260812)의 단일 실험 1건에 한정된 검증이다. Spectrum의 \(x_0\) 예측은 수학적으로 완전한 무손실(lossless) 계산이 아니며, 근사 예측에 따른 미세한 잠재공간 오차가 존재한다. 따라서 이 결과가 기준선과의 완벽한 수치적 일치를 의미하거나, 임의의 다른 프롬프트와 시드에서도 품질 저하가 전혀 발생하지 않는다는 무손실 품질을 보증하는 것은 아니다.

    7. 같은 가중치로 기준선과 비교하기

    Spectrum은 어느 스텝을 직접 계산할지 바꾸며, 모델 가중치를 다시 양자화하거나 변환하는 방식이 아니다.

    같은 84개 FP16 RKNN 모델을 사용하므로, 예측 캐싱을 끄면 모든 스텝을 계산하는 기준선으로 돌아갈 수 있다.

    • 같은 프롬프트·시드·스텝 수로 캐싱을 켠 결과와 끈 결과를 비교한다.
    • 수치 안정성뿐 아니라 최종 생성 이미지의 화질도 함께 확인한다.
    • 새 조건에서 품질이 기준에 못 미치면 예측을 끄고 전체 스텝을 계산한다.

    이번 조건에서는 총 생성 시간이 41.02% 줄었다. 다른 프롬프트와 시드에 적용할 때도 기준선과 화질을 비교한 뒤 사용할 필요가 있다. 3편에서는 연산 속도를 줄여도 화질이나 메모리 때문에 채택하지 못한 다른 최적화를 살펴본다.

  • Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험

    Anima RKNN 최적화의 한계: W8A8 화질 실패와 8GB 모델 상주 실험

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.


    1. 더 빠른 추론을 위한 두 가지 시도

    ROCK 5C 8GB에서 Anima 추론을 실행한 뒤, FFN 양자화와 모델 상주라는 두 가지 최적화를 비교했다. 보드는 RK3588S2를 탑재했으며, 실험은 2026년 8월 RKNN-Toolkit2 2.3.2 환경에서 진행했다.

    1편과 같은 84개 FP16 RKNN 분할 구성을 기준으로 삼았다. NPU가 attention과 FFN을 처리하고 CPU가 AdaLN과 FP32 잔차 누적을 담당한다. 이번 질문은 계산을 더 빠르게 하거나, 반복되는 모델 준비 시간을 줄일 수 있는가다.

    512×512 고정 해상도에서 84개 서브그래프를 순차 실행하는 구조는 매 스텝마다 모델을 로드, 초기화, 해제하는 고유한 오버헤드를 발생시킨다. 이에 따라 시스템 최적화를 위한 두 가지 핵심 가설을 설정했다. 1. 연산 가속 가설: 연산 부하가 큰 FFN 레이어에 W8A8 정수 양자화를 적용해 NPU 실행 시간을 단축한다. 2. 라이프사이클 단축 가설: 84개 RKNN 모델의 런타임 컨텍스트를 메모리에 상주(Resident Context)시켜 매 스텝 반복되는 로드 및 초기화 시간을 제거한다.

    이 두 가지 접근법을 ROCK 5C 8GB 환경에서 실측 검증한 결과, 화질 저하와 물리 메모리 한계라는 구체적인 병목에 직면했다.


    2. FFN 양자화로 디노이징 시간 18.48% 단축

    DiT의 전체 84개 RKNN 서브그래프 중 연산량이 집중된 28개 블록의 FFN(Feed-Forward Network) 영역에 정수 양자화를 적용했다. FFN 내부의 Linear(2048→8192) 및 Linear(8192→2048) 레이어의 weight와 activation을 INT8로 양자화(W8A8)하고, 비선형 활성화 함수인 GELU와 분기 출력부는 FP16으로 유지하는 하이브리드 빌드 방식을 채택했다. self-attention 및 cross-attention 코어는 기존 FP16 구성을 유지했으며, 호스트 측의 residual stream 역시 FP32 정밀도를 보존했다.

    양자화 보정에는 기존 FP16 디노이징 과정에서 수집한 활성화 텐서를 사용했다. 높은 시그마·낮은 시그마와 조건부·무조건부 CFG 분기를 조합해 블록당 4개, 총 112개를 수집했다. 28개 FFN 블록이 모두 변환되었다.

    동일한 초기 잠재 변수(seed: 20260812), 프롬프트 컨텍스트, CFG 4.0 스케일, 20스텝 조건에서 성능을 비교 측정한 결과는 다음과 같다.

    항목 기존 FP16 FFN Linear W8A8 변화량
    20스텝 디노이즈 시간 2,408.54초 1,963.45초 445.09초 단축 (18.48% 개선)
    스텝당 평균 소요 시간 120.40초 98.15초 22.25초 단축
    스텝당 평균 FFN 코어 실행 44.76초 23.57초 1.90배 가속
    스텝당 평균 Self 코어 실행 24.00초 25.74초 실행 편차 수준
    스텝당 평균 Cross 코어 실행 7.45초 7.69초 실행 편차 수준

    전체 디노이징은 1.227배, 양자화를 적용한 FFN 구간은 1.90배 빨라졌다. 실행 중 NaN과 Inf는 발생하지 않았다.


    3. 실행은 빨라졌지만 화질은 기준 미달

    디노이징 시간은 18.48% 줄었지만, VAE 디코딩을 거친 512×512 이미지는 육안 화질 기준을 충족하지 못했다.

    수치가 발산하지 않는 것과 이미지의 품질이 충분한 것은 별개였다. 이번 W8A8 구성은 수치 안정성은 유지했지만 화질 기준을 통과하지 못했다.

    따라서 FFN 양자화는 채택하지 않고 FP16 구성으로 돌아갔다. 생성 모델의 최적화는 실행 시간뿐 아니라 최종 이미지 품질을 함께 비교해야 한다.


    4. 모델을 메모리에 두면 줄일 수 있는 시간

    화질 저하 없이 추론 시간을 단축하기 위해 다음으로 검토한 가설은 84개 서브그래프의 로드 및 초기화 오버헤드를 제거하는 런타임 모델 상주(Resident Context) 방식이다.

    분할 구성은 각 모델을 로드하고 런타임을 초기화한 뒤 추론을 수행하고 해제한다. 84개 모델을 한 번 순회하는 이 준비·정리 비용을 3회 측정한 평균은 다음과 같다.

    라이프사이클 단계 84개 모델 1회 순회 소요 시간 (평균) 비고
    load_rknn 13.96초 호스트 메모리로 모델 가중치 로드
    init_runtime 12.90초 NPU 드라이버 컨텍스트 생성 및 DMA 매핑
    release 4.84초 NPU 런타임 및 디바이스 매핑 해제
    순수 단계 합계 31.71초 루프 오버헤드 포함 wall time: 33.84초

    분기별 모델당 평균 라이프사이클 시간은 self-attention 0.423초, cross-attention 0.200초, FFN 0.510초로 나타났다.

    28스텝 Spectrum 샘플러 운용 조건에서는 전체 28스텝 중 15스텝이 예측 연산으로 대체되고 실제 NPU 연산은 13회의 compute 스텝에 걸쳐 발생한다. 따라서 이미지 1장을 생성할 때 수행되는 총 라이프사이클 횟수는 84 models × 13 steps = 1,092회이며, 순수 라이프사이클 누적 시간은 약 412.2초에 달한다.

    만약 84개 컨텍스트를 메모리에 상시 상주시키는 것이 가능하다면, 최초 1회의 준비(load/init) 및 최종 1회의 해제(release)에 소요되는 31.71초를 제외한 나머지 12회분의 라이프사이클 시간을 이론적으로 제거할 수 있다.

    \[\Delta T_{\text{theoretical}} = 31.708\,\text{s} \times (13 – 1) = 380.50\,\text{s} \approx 6.34\,\text{분}\]

    이 계산에 따르면 평균 28.56분(1,713.78초)이 소요되던 전체 생성 시간을 22.22분(1,333.28초)까지 단축할 수 있다는 계산이 성립한다. 그러나 이 수치는 84개 컨텍스트 상주가 물리적으로 가능하다는 전제하에 도출된 이론적 상한일 뿐이며, 실제 상주 디노이즈 파이프라인에서 측정되거나 달성된 성능이 아니다.


    5. 18개 컨텍스트에서 드러난 메모리 한계

    모델을 하나씩 메모리에 올리면서 실제 메모리 점유와 스왑 증가량을 측정했다. 전체 상주를 실행하기 전에 8GB 환경에서 감당할 수 있는지 확인하기 위한 실험이다.

    벤치마크의 안전 중단 조건은 여유 메모리(MemAvailable) 1.5 GiB 미만 또는 시스템 스왑 16 MiB 초과로 설정했다. 1개부터 순차적으로 컨텍스트를 로드한 결과는 다음과 같다.

    상주 컨텍스트 수 프로세스 절대 PSS 기준선 대비 추가 PSS MemAvailable 변화 시스템 스왑 증가량
    1개 365.4 MiB 154.9 MiB -151.8 MiB 0 MiB
    4개 765.6 MiB 555.1 MiB -558.5 MiB 0 MiB
    8개 1,262.6 MiB 1,052.1 MiB -1,000.3 MiB 1.3 MiB
    12개 1,823.3 MiB 1,612.8 MiB -1,567.6 MiB 5.0 MiB
    16개 2,354.9 MiB 2,144.4 MiB -2,104.2 MiB 9.0 MiB
    18개 2,631.4 MiB 2,420.9 MiB -2,372.5 MiB 21.4 MiB (중단)

    18번째 컨텍스트를 로드하는 시점에서 프로세스의 절대 PSS는 약 2.57 GiB(2,631.4 MiB)에 도달했으며, 기준선 대비 추가 PSS는 약 2.36 GiB(2,420.9 MiB)를 기록했다. 시스템 스왑이 기준선 대비 21.4 MiB 증가하여 안전 기준(16 MiB 초과)에 의해 실험이 조기 중단되었다. 로드된 18개 컨텍스트는 즉각 안전하게 해제(release wall time: 1.05초)되었으며 디바이스 매핑이 회수되었다.

    메모리 증가는 호스트 텐서뿐 아니라 NPU 드라이버의 디바이스 매핑에서도 나타났다. 16개 컨텍스트를 유지했을 때 디바이스 매핑이 약 1.357 GiB였고, 30초 유지 중 시스템 스왑은 19.5 MiB 증가했다.

    16~18개 컨텍스트의 실측 메모리 증가율을 바탕으로 84개 전체 모델 상주 시의 소요량을 선형 외삽하면 다음과 같은 계산이 나온다. – 예상 디바이스 매핑 메모리: 약 7.1 GiB – 예상 프로세스 총 추가 PSS: 약 11.3 GiB

    ROCK 5C 보드의 전체 물리 RAM은 7.75 GiB다. OS 기본 점유 메모리, CPU 호스트 측 가중치 및 연산 버퍼(약 0.8~1.0 GiB), 프롬프트 인코더와 VAE 디코더의 상주 공간을 감안하기 이전에도 추가 PSS 11.3 GiB의 메모리 요구량은 하드웨어 한계를 초과한다. 따라서 84개 서브그래프의 동시 상주는 메모리 게이트를 통과할 수 없다.


    6. 작은 LRU 캐시로 해결할 수 있을까

    전체 84개 상주가 불가능하다면, 4~16개 정도의 제한된 컨텍스트 풀을 LRU(Least Recently Used) 방식으로 운용하거나 일부 모델만 고정 상주시키는 대안을 검토할 수 있다.

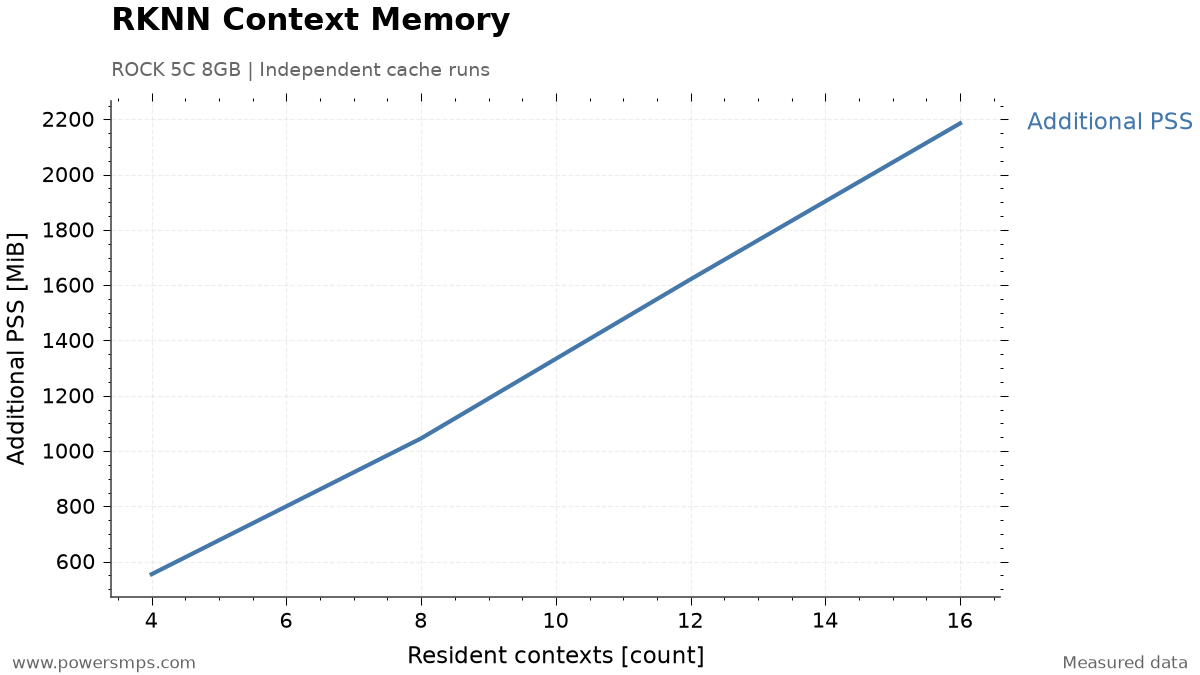
    새로운 독립 프로세스에서 4, 8, 12, 16개 컨텍스트 풀을 할당하여 실측한 추가 PSS 메모리는 각각 554.8 MiB(약 0.54 GiB), 1,046.1 MiB(약 1.02 GiB), 1,621.5 MiB(약 1.58 GiB), 2,185.4 MiB(약 2.13 GiB)였다.

    Radxa ROCK 5C 8GB 환경에서 독립 프로세스 실행 시 RKNN 상주 컨텍스트 수(4, 8, 12, 16개)에 따른 추가 PSS(MiB) 실측 증가 추이.
    Radxa ROCK 5C 8GB 환경에서 독립 프로세스 실행 시 RKNN 상주 컨텍스트 수(4, 8, 12, 16개)에 따른 추가 PSS(MiB) 실측 증가 추이.

    컨텍스트 증가에 따라 추가 PSS는 대체로 증가하는 경향을 나타내지만 엄밀한 완전 선형 관계는 아니다. 또한 이러한 제한 캐시 전략은 DiT의 순방향 연산 구조로 인해 실효성을 상실한다.

    스텝 n의 순차 호출열 (총 84개 모델)
    [Model 00 (self) → Model 01 (cross) → Model 02 (FFN) → ... → Model 83 (FFN)]
      ↓ 잔차 연결 누적 및 스케줄러 잠재 변수 갱신
    스텝 n+1의 순차 호출열 (총 84개 모델 동일 순회)
    [Model 00 (self) → Model 01 (cross) → Model 02 (FFN) → ... → Model 83 (FFN)]
    

    DiT 블록의 각 분기 출력은 즉시 호스트의 FP32 residual stream에 합산되어 다음 분기 및 블록의 입력으로 주입된다. 또한 84개 분기 연산이 모두 완료된 후에야 샘플러가 디노이즈 잠재 변수를 갱신하고 다음 디퓨전 스텝으로 진행할 수 있다. 즉, 모델 간의 순차적 의존성 때문에 호출 루프의 순서를 바꾸는 루프 인터체인지(Loop Interchange)가 불가능하다.

    구조상 84개 모델은 고정된 순서로 1스텝당 1회씩 순환 참조된다. 같은 모델이 다시 호출되기 전에는 다른 83개 모델을 거친다. 따라서 캐시 용량이 84 미만인 일반 LRU 캐시(예: capacity 4, 8, 16, 28, 56 등)를 적용할 경우, 캐시에 적재된 모델은 재사용되기 직전에 반드시 캐시 밖으로 축출된다. – LRU 시뮬레이션 결과: 총 1,092회 호출 중 0 hit / 1,092 miss (캐시 적중률 0%)

    일부 모델(예: 0~15번 모델)을 축출 없이 메모리에 고정 적재하는 방식(Static Pinning)을 적용하더라도, 16개 모델 기준 절감 가능한 시간은 compute 스텝당 16개분의 라이프사이클에 불과하여 이미지 1장당 이론상 최대 약 72.4초 절감에 그치며 이는 실제 달성된 측정값이 아니다. 반면 이를 위해 지불해야 하는 비용은 2.13 GiB(2,185.4 MiB)의 추가 PSS 점유와 장기 유지 시 발생하는 스왑이다. 72.4초의 제한된 이론적 절감을 위해 시스템 안정성을 희생하고 스왑 지터를 유발하는 것은 엔지니어링 관점에서 불합리한 선택이다.


    7. 8GB에서 유지한 구성

    W8A8 FFN 정수 양자화와 모델 상주 컨텍스트 캐시 실험을 통해 도출된 핵심 병목과 검증 결과는 다음과 같다.

    • FFN W8A8 양자화: 계산은 빨라졌지만 육안 화질 기준에 못 미쳤다.
    • 전체 모델 상주: 18개 컨텍스트에서 스왑이 늘었고, 84개 상주의 추가 PSS는 약 11.3 GiB로 외삽됐다.
    • 제한 캐시: 순환 호출에서는 재사용 전에 축출되어 LRU 적중을 얻지 못했다.

    ROCK 5C 8GB에서는 FP16 모델을 유지하고, 필요한 모델만 준비해 실행한 뒤 해제하는 방식을 선택했다. 이번 비교에서는 상주 시간을 늘리는 이득보다 메모리 부담이 컸다.

    이 판단은 이번 8GB 보드와 분할 구성에 대한 결과다. 메모리 용량이나 모델 분할 방식이 달라지면 상주의 손익도 다시 비교해야 한다.

    모델을 메모리에 쌓아두는 대신, 84개로 나뉜 그래프를 더 적은 수로 합칠 수는 없을까? 4편에서는 컴파일러 버전을 바꾸어 그래프 융합을 시도하고 속도·메모리 비용을 비교한다.

  • RKNN Toolkit 2.3.2와 2.3.0 비교: AdaLN 컴파일 충돌과 fusion 실험

    RKNN Toolkit 2.3.2와 2.3.0 비교: AdaLN 컴파일 충돌과 fusion 실험

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.


    1. 분할한 DiT 블록을 다시 합칠 수 있을까

    임베디드 NPU 환경에서 생성형 확산 모델(Diffusion Transformer)을 구동할 때, 런타임 메모리 제한과 연산자 지원 여부는 아키텍처 설계를 직접 결정짓는 핵심 요인이다. 이번 심화 실험은 2026년 8월 20일 Radxa ROCK 5C 8GB 단일 보드 컴퓨터 환경에서 진행되었다.

    실험에는 직접 구매한 ROCK 5C 8GB 보드를 사용했다.

    실험 보드는 RK3588S2 기반 ROCK 5C이며, RKNN 타깃은 rk3588이다. 같은 판매 페이지의 ROCK 5C Lite와 구분해야 한다.

    1편의 Anima 구성은 28개 DiT 블록을 각각 attention·cross-attention·FFN으로 나눈 84개 FP16 RKNN 모델이다. AdaLN과 잔차 연결은 CPU에서 처리한다. 여기서는 블록당 3개 모델을 하나로 합칠 수 있는지 살펴봤다.

    기존 파이프라인에서는 AdaLN(Adaptive LayerNorm) 연산과 잔차 연결(Residual Addition)을 호스트 CPU 파이썬 런타임에서 처리해 왔다. 그러나 단일 DiT 블록 내에서 3개의 서브그래프를 매 스텝마다 각각 로드·실행·해제하고 중간 결과를 CPU 호스트로 왕복시키는 구조는 상당한 드라이버 오버헤드를 발생시킨다. 만약 블록 내의 Self-Attention, Cross-Attention, FFN 및 AdaLN을 단일 RKNN 그래프로 융합(fused 1-model)할 수 있다면, 블록당 라이프사이클 호출 횟수를 3회에서 1회로 줄이고 호스트 텐서 전송 비용을 절감할 수 있을 것으로 기대되었다.

    그러나 당시 기본 컴파일러로 사용하던 RKNN Toolkit 2.3.2 환경에서 AdaLN 연산자가 포함된 그래프를 컴파일할 때 치명적인 컴파일러 세그멘테이션 폴트(SIGSEGV, exit code 139)가 발생했다. 이 크래시가 Anima DiT 구조 자체의 근본적인 하드웨어 비지원인지, 컴파일러 버그인지 검증하는 작업이 선행되어야 했다.


    2. 같은 AdaLN 그래프를 다른 툴킷으로 빌드하기

    컴파일러 충돌 문제를 분석하기 위해, 거대한 전체 DiT 블록 대신 충돌을 유발하는 AdaLN 연산자만 격리한 최소 재현용 ONNX 모델(Minimal AdaLN reproducer)을 추출하여 컴파일 실험을 수행했다.

    같은 AdaLN 재현 그래프를 RKNN Toolkit 2.3.2와 2.3.0으로 각각 빌드했다. 다른 조건은 유지하고 컴파일러 버전에 따른 결과를 비교했다.

    동일한 reproducer ONNX 모델, 동일한 타깃(rk3588), 동일한 단일 코어 최적화 옵션에서 측정된 빌드 결과는 다음과 같다.

    툴킷 버전AdaLN 그래프 빌드종료 코드
    2.3.2실패: SIGSEGV139
    2.3.0성공0

    2.3.2에서는 LayerNorm 관련 그래프 최적화 뒤 SIGSEGV로 빌드가 중단됐다. 2.3.0에서는 같은 그래프가 정상적으로 빌드됐다.

    동일한 입력 그래프와 타깃에서 버전에 따라 결과가 달라져, 이번 실패는 컴파일러 회귀 문제로 판단했다. 이전 버전인 2.3.0이 이번 그래프의 회피 경로가 되었으며, 새 버전으로 올려 해결한 사례는 아니다.


    3. 64px·512px 융합 모델 실행 확인

    Toolkit 2.3.0으로 첫 번째 DiT 블록의 융합 모델을 빌드했다. 64px 테스트 구성과 512px 실제 추론 구성을 나누어 확인했다.

    융합 블록 해상도RKNN 변환보드에서 실행
    64px성공초기화·추론 확인
    512px성공초기화·추론·해제 확인

    512px 모델 빌드는 스왑 없이 완료됐다. 일부 Transpose와 Erf 연산은 CPU로 배치되었으므로, 단일 RKNN 파일로 합쳤다고 해서 모든 연산이 NPU에서 실행되는 것은 아니다.

    더 중요한 검증 포인트는 타깃 보드 로컬 런타임과의 바이너리 호환성이었다. 컴파일러를 2.3.0으로 빌드했더라도 보드 OS의 RKNPU 커널 드라이버나 런타임 라이브러리를 강제로 교체해야 한다면 배포 복잡도가 급격히 상승한다.

    빌드한 모델은 런타임 API 2.3.0·드라이버 0.9.8 환경에서 실행했다. 커널이나 드라이버를 교체하지 않고 로드·초기화·추론·해제를 확인했으며, 조건부·무조건부 추론을 3라운드 반복했다.

    이번 단일 블록 검증에서는 컴파일러 환경만 바꾸어도 기존 보드 런타임에서 실행할 수 있었다.


    4. 단일 블록 출력의 수치 차이

    융합 모델의 하드웨어 실행이 확인된 후, NPU 융합 연산 결과가 원본 부동소수점 기준 텐서와 수치적으로 일치하는지 단일 블록 수치 검증(Correctness Gate)을 수행했다. 기준 참조 텐서는 PyTorch FP16 원본 블록 연산 결과와 ONNX Runtime(ORT) 결과다.

    대상 아키텍처 기준 참조 텐서 (Reference) 코사인 유사도 (Cosine) 최대 절대 오차 (Max Abs) 평균 절대 오차 (Mean Abs) 평균 제곱 오차 (MSE) NaN/Inf 검출
    64px Fused PyTorch 0.99998315 0.28125 0.0018879 4.2748e-05 0 / 0
    64px Fused ONNX Runtime 0.99998608 0.28125 0.0018948 3.5387e-05 0 / 0
    512px Split (기존) PyTorch 0.99999881 0.14937 0.0002283 1.0841e-06 0 / 0
    512px Fused (후보) PyTorch 0.99997673 0.25000 0.0011279 2.1100e-05 0 / 0
    512px Fused (후보) ONNX Runtime 0.99997590 0.28906 0.0011662 2.1854e-05 0 / 0

    512px 융합 모델은 PyTorch 기준 출력과의 코사인 유사도 0.99997673, 최대 절대 오차 0.25000을 기록했고 NaN과 Inf는 발생하지 않았다.

    다만 융합 모델의 MSE는 2.1100e-05로, 기존 분할 방식의 1.0841e-06보다 약 19.5배 컸다. 단일 블록의 높은 코사인 유사도만으로는 전체 28개 블록과 여러 스텝을 거친 최종 이미지의 화질까지 확인할 수 없다.


    5. 호출은 줄었지만 속도 이득은 0.47%

    서브그래프 융합을 추진했던 가장 핵심적인 목적은 지연 시간 단축이었다. 호스트 파이썬에서 실행되던 AdaLN 및 잔차 연산을 컴파일된 그래프 내부로 옮기고 드라이버 컨텍스트 호출 횟수를 줄임으로써 속도 향상을 기대했다.

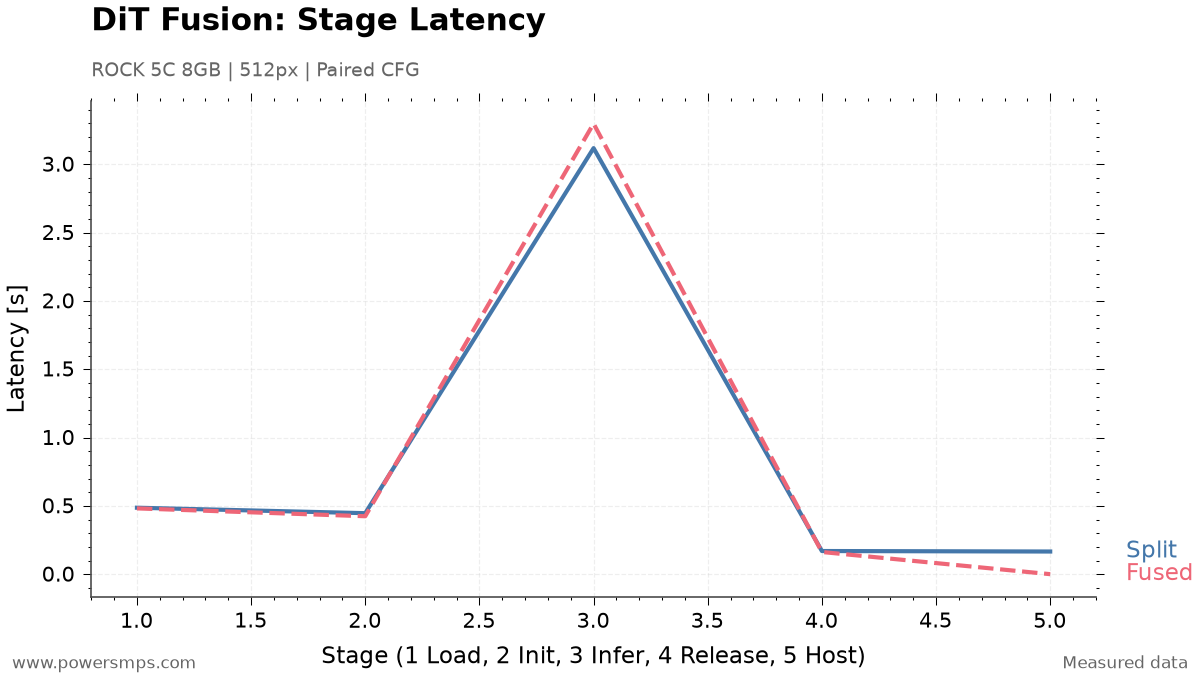
    ROCK 5C 보드에서 512px 단일 블록에 대해 CFG(Classifier-Free Guidance) 2회 연산 스트림을 3라운드 실행하고, 각 단계별 소요 시간의 평균치를 정밀 계측했다.

    512px DiT 단일 블록의 구성요소별 실측 시간. 1=load, 2=init, 3=inference×2, 4=release, 5=host AdaLN/residual. 구성요소 합계는 Split 4.3856초, Fused 4.3650초다.
    Comparison of component latency breakdown between Split 3-Model baseline and Fused 1-Model candidate for 512px single block on Radxa ROCK 5C.

    아래 표는 기존 3-model 분할 방식과 Fused 1-model 방식의 단계별 실측 수치 비교다.

    실행 단계 및 구성요소 기존 3-Model Split Fused 1-Model 후보 Fused 변동량 변동 원인 및 분석
    Model Load 0.4863초 0.4814초 -0.0049초 가중치 파일 로딩 시간 (단일 블록 기준 미미한 단축)
    Runtime Init 0.4464초 0.4240초 -0.0224초 NPU 런타임 컨텍스트 초기화 시간 소폭 단축
    NPU Inference (×2) 3.1177초 3.2972초 +0.1795초 (+5.76%) 연산자 융합에 따른 NPU 실행 지연 발생
    Context Release 0.1694초 0.1623초 -0.0071초 컨텍스트 메모리 해제 시간
    Host AdaLN & Residual 0.1658초 0.0000초 -0.1658초 (-100%) 별도 Python 호스트 AdaLN 경로 제거
    순수 구성요소 합계 4.3856초 4.3650초 -0.0206초 (-0.47%) 실제 획득된 순수 단축 시간은 0.0206초에 불과
    계측 Wall Time 4.7379초 4.4981초 -0.2398초 (-5.06%) 분할 모드의 다중 메모리 스냅샷 계측 왜곡치 포함

    실측 데이터는 직관적인 예상과 상반된 병목 현상을 보여주었다. 첫째, 호스트 연산 시간인 0.1658초는 Fused 모델에서 완전히 0초로 제거되었다. 그러나 NPU의 순수 순방향 추론 시간(Inference ×2)이 기존 3.1177초에서 3.2972초로 +0.1795초(+5.76%) 증가했다. 융합 구성에서 추론 시간이 늘어나면서, 호스트 연산 제거로 얻은 이득(0.1658초)을 완전히 상쇄했다.

    둘째, 컨텍스트 호출 횟수는 3회에서 1회로 66.7% 줄어들었으나, 수명주기(Load, Init, Release) 오버헤드는 기대만큼 줄어들지 않았다. 단일 블록의 수명주기 총 시간은 기존 1.1021초에서 1.0678초로 3.1% 단축되는 데 그쳤다. RKNPU 드라이버의 실제 초기화 및 로드 오버헤드는 단순한 C API 호출 횟수보다 모델 파일의 전체 가중치 용량(약 140~155 MB)과 그래프 복잡도에 지배된다는 사실이 드러났다.

    셋째, 계측된 Wall Time상으로는 0.2398초(5.06%)가 줄어든 것처럼 관측되지만, 이는 분할 모드에서 3개의 서브 컨텍스트마다 디버깅용 메모리 스냅샷을 6회 반복 수집한 계측 오버헤드가 포함된 수치다. 스냅샷 계측 왜곡을 배제한 순수 구성요소 합계 기준 실제 단축 효과는 블록당 0.0206초(-0.47%)에 불과했다.


    6. NPU 디바이스 매핑은 94.30 MiB 증가

    지연 시간 단축 효과가 미미한 반면, 런타임 메모리 측면에서는 심각한 손실이 발생했다. 보드 레벨에서 계측된 메모리 지표는 다음과 같다.

    메모리 측정 지표 기존 3-Model Split Fused 1-Model 후보 차이 및 증감률
    NPU 디바이스 매핑 디바이스 PSS 127,144 KiB 223,704 KiB +96,560 KiB (+94.30 MiB, +75.9%)
    실행 시 피크 프로세스 PSS 648,282 KiB 694,882 KiB +46,600 KiB (+45.51 MiB, +7.2%)
    신규 시스템 스왑(Swap) 발생량 0 0 0 (단일 블록 기준 안전)

    분할 방식은 각 브랜치를 순서대로 실행한 뒤 해제한다. 한 번에 유지하는 NPU 디바이스 매핑의 피크는 127,144 KiB, 약 124.16 MiB였다.

    융합 방식은 블록 전체를 하나의 런타임 컨텍스트로 유지한다. 디바이스 매핑은 223,704 KiB, 약 218.46 MiB로 늘어 추가로 94.30 MiB를 차지했다.

    총 8GB의 LPDDR4X 메모리를 공유하는 ROCK 5C 환경에서, 백그라운드 OS와 텍스트 인코더, VAE가 공존해야 하는 상황에 디바이스 매핑 메모리가 75.9%나 급증하는 것은 심각한 시스템 압박 요인이다.


    7. 융합을 채택하지 않은 이유

    단일 블록의 차이를 전체 구성에 외삽한 예상 절감량은 약 7.51초였다. 이는 전체 이미지 생성을 실행해 측정한 결과가 아니다.

    • 속도: 호스트 연산을 줄인 이득이 NPU 추론 지연 증가로 대부분 상쇄됐다.
    • 메모리: 같은 블록을 실행하는 데 필요한 디바이스 매핑이 늘었다.
    • 정밀도: 단일 블록의 코사인 유사도는 높았지만 MSE는 기존 분할 방식보다 커졌다.

    속도 이득은 0.47%에 그쳤고 메모리 사용량은 늘었으므로, 이번 보드에서는 기존 분할 방식을 유지했다.

    검증 범위는 단일 블록에 한정된다. 전체 28개 블록을 융합해 이미지를 생성하는 실험이나 장시간 운용 검증까지 진행한 결과는 아니다.

    3편의 상주 실험과 이번 융합 실험 모두, 호출 횟수를 줄이는 것만으로는 전체 성능을 설명할 수 없었다. NPU 연산 시간과 메모리 비용까지 함께 비교해야 8GB 보드에서 실제로 쓸 수 있는 최적화를 고를 수 있다.

  • RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과

    RK3588에서 Anima 이미지 생성하기: ROCK 5C 8GB의 RKNN 변환과 실행 결과

    제휴 링크 안내: 이 글에는 알리익스프레스 제휴 링크가 포함되어 있으며, 링크를 통해 구매하면 작성자가 수수료를 받습니다.

    1. ROCK 5C 8GB에서 Anima 실행하기

    8GB 메모리를 탑재한 단일 보드 컴퓨터(Single Board Computer, SBC)인 Radxa ROCK 5C 8GB 환경에서 수십억 파라미터 규모의 Diffusion Transformer(DiT) 모델 온디바이스 구동을 검증했다.

    보드 메인 프로세서는 Rockchip RK3588S2 SoC이며, Rockchip 전용 NPU 런타임 타깃은 rk3588이다. 동일 제조사의 Radxa ROCK 5C 상품군 중 Lite 모델인 RK3582 옵션은 NPU 유닛 및 CPU 코어 구성이 축소된 별개 칩셋이다. 따라서 8GB DiT 연산 파이프라인 재현을 위해서는 반드시 RK3588S2 기반의 ROCK 5C 8GB 모델을 확인해야 한다.

    Anima의 이미지 생성을 담당하는 DiT는 28개 블록으로 구성된다. 이번 실험에서는 이를 ROCK 5C의 NPU에서 실행할 수 있는 형태로 나누어 변환했다.

    온디바이스 변환의 고정 입출력 사양은 다음과 같다: – 배치 크기: 1 – 생성 해상도: 512×512 픽셀 – 입력 토큰 규격: 이미지 토큰 1024개, 텍스트 컨디셔닝 토큰 512개 – ONNX 타깃 버전: Opset 19

    텍스트 인코딩에는 Qwen3, 이미지 복원에는 Qwen-Image VAE를 사용했다. DiT의 주요 연산은 NPU가 처리하고, 텍스트 인코딩과 VAE 디코딩은 CPU가 담당하는 구성이다.


    2. DiT를 84개 RKNN 모델로 나눈 이유

    DiT 아키텍처의 28개 블록 전체를 단일 거대 RKNN 모델로 패키징하는 방식은 RKNN 컴파일러의 구조적 한계에 부딪혔다. 2026년 8월 실험 당시 사용된 RKNN-Toolkit2 2.3.2 환경에서 DiT 블록 전체를 컴파일하거나 AdaLN(Adaptive Layer Normalization) 연산이 결합된 브랜치를 빌드할 때 네이티브 세그폴트(native segfault, exit 139)가 발생했다.

    디버깅을 위해 그래프를 최소 단위로 분해한 결과, 대용량 Linear 레이어나 표준 GELU FFN 그래프는 NPU 타깃으로 정상 빌드되었으나, AdaLN LayerNorm + broadcast shift/scale/gate 패턴이 포함된 서브그래프는 가중치 크기와 무관하게 동일한 세그폴트를 일으켰다. 메모리 부족 문제가 아니라 컴파일러의 특정 그래프 연산자 패턴 해석 오류임이 확인되었다.

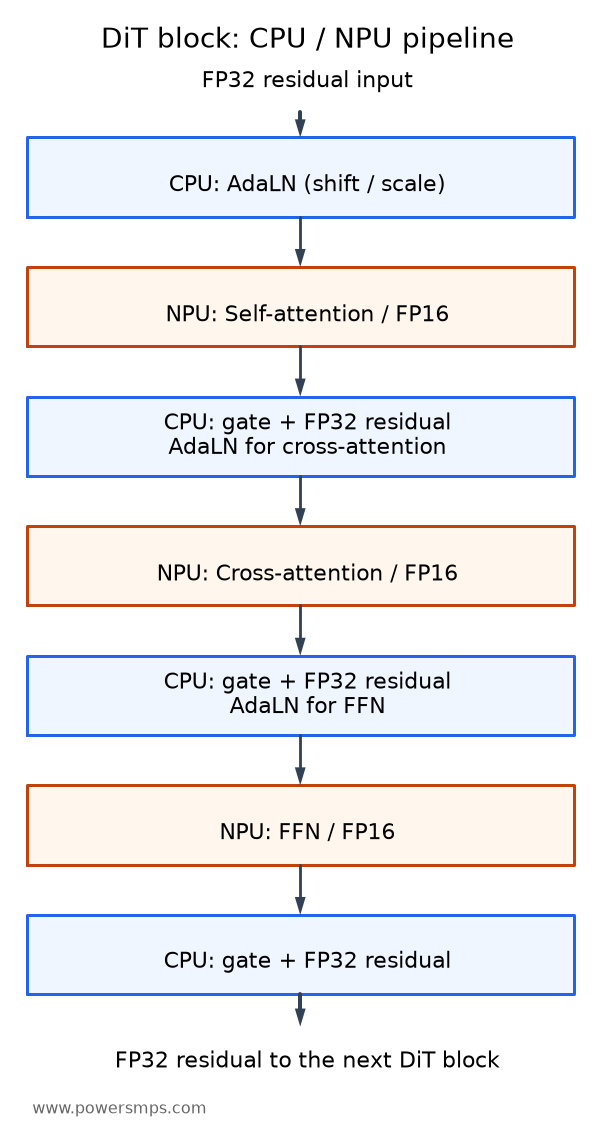
    각 DiT 블록에서 NPU로 실행할 수 있는 3개 연산 분기를 분리하고, 정규화·게이트·잔차 합산은 CPU에서 처리했다.

    28개 DiT 블록을 각각 self-attention, cross-attention, FFN의 3개 서브그래프로 나누었다. self-attention은 이미지 토큰 사이의 관계를, cross-attention은 텍스트 조건과 이미지 토큰의 관계를 계산한다. FFN은 각 토큰의 특징을 변환한다.

    파란 CPU 단계와 주황 NPU 단계를 번갈아 실행하는 DiT 블록 구조. CPU는 각 분기의 AdaLN과 게이트 곱셈·FP32 잔차 누적을, NPU는 FP16 self-attention·cross-attention·FFN을 처리한다.
    DiT 블록 하나의 CPU·NPU 실행 순서. NPU는 FP16 attention·FFN을, CPU는 각 분기 앞의 AdaLN과 분기 뒤의 게이트 곱셈·FP32 잔차 누적을 처리한다. 이 구조가 28개 블록에서 반복된다.

    총 84개(28 × 3)의 FP16 RKNN 모델이 만들어졌으며, 크기 합계는 약 3.99GB다. AdaLN, 게이트 곱셈, RoPE, 입력·타임스텝 임베딩과 최종 프로젝션은 CPU에서 처리했다. 잔차 누적은 FP32로 유지했다.

    • 원본 모델에서 CPU가 처리할 연산과 NPU가 처리할 연산을 분리한다.
    • NPU용 연산을 고정 입출력 형상의 ONNX 그래프로 만든 뒤 RKNN으로 변환한다.
    • 단일 블록과 전체 블록의 출력을 원본과 비교한 다음 이미지 생성을 실행한다.

    3. 변환 전후 출력은 얼마나 비슷한가

    하이브리드 분할 변환에서 가장 중요한 단계는 프레임워크 간 수치 오차의 누적 방지다. 단일 블록 검증과 28개 전체 블록의 순차 누적 검증을 나누어 수행했다.

    단일 블록 비교

    원본 PyTorch 블록의 FP16 분기 연산과 FP32 잔차 누적을 기준으로 ONNX 및 RKNN 출력을 비교했다. 변환한 연산이 원래 모델과 같은 방향의 출력을 내는지 확인하는 과정이다.

    비교 대상 코사인 유사도 (Cosine) 평균 절대 오차 (MAE) 최대 절대 오차 (Max AE) NaN / Inf 발생
    PyTorch → ONNX 0.9999994183 0.00012350 0.09396 0 / 0
    PyTorch → RKNN 0.9999990896 0.00019535 0.11446 0 / 0
    ONNX → RKNN 0.9999995474 0.00014175 0.06969 0 / 0

    PyTorch 기준 출력과 RKNN 출력의 코사인 유사도는 0.9999990896이었다. 단일 블록에서는 변환 전후 출력이 매우 비슷한 방향을 유지했다.

    28개 블록을 통과한 출력 비교

    Block 0부터 Block 27까지 28개 블록 전체를 통과하는 동안 수치 오차가 증폭되지 않는지 확인하기 위해 순수 ONNX 누적 텐서와 RKNN 84코어 누적 텐서를 비교했다.

    • 개별 블록 최저 코사인 유사도: 0.999993668 (전체 28개 블록 중 최저치)
    • 최종 히든 레이어 유사도 (Hidden Cosine): 0.9999989412
    • 최종 16채널 예측 텐서 유사도 (Final Prediction Cosine): 0.9999989072
    • 최종 예측 텐서 MAE: 0.00129712
    • 최종 예측 텐서 Max AE: 0.00830078
    • 경계 구간 NaN / Inf 발생 건수: 0건

    28개 블록을 통과한 뒤에도 NaN이나 Inf는 발생하지 않았고, 기준 출력과 높은 유사도를 유지했다. 다만 이 수치 비교와 최종 생성 이미지의 화질 평가는 구분해야 한다.


    4. 디노이징에는 얼마나 걸렸나

    28블록 전체 forward의 분기별 순수 NPU 시간

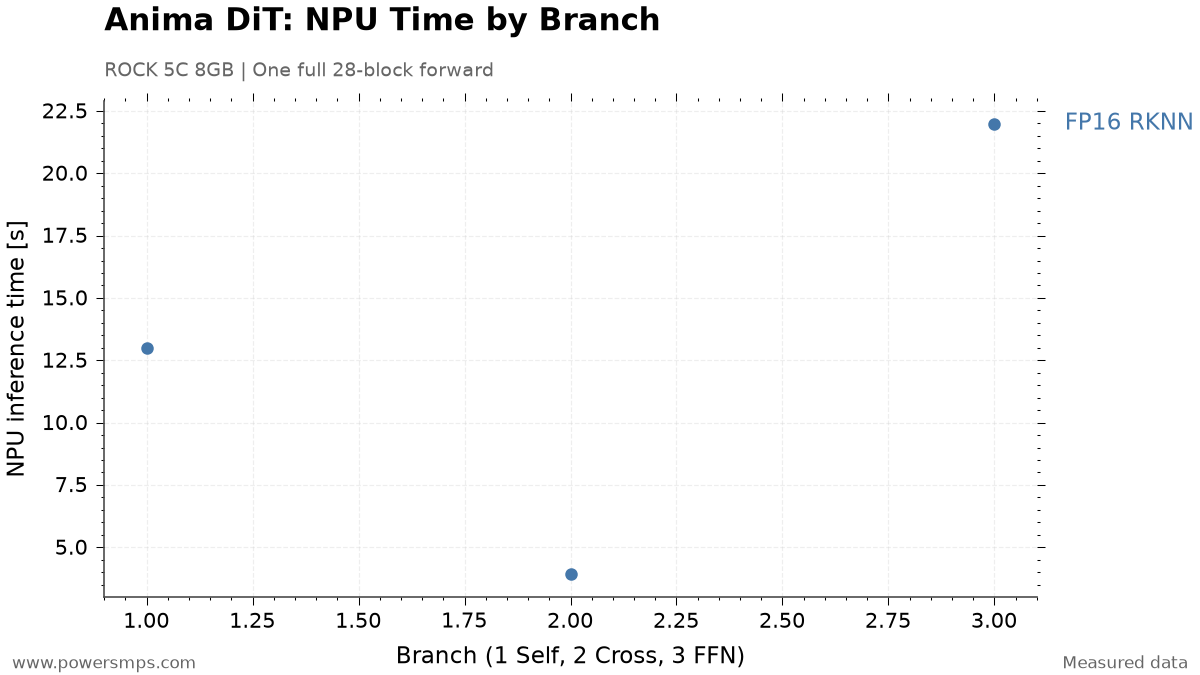
    RK3588 NPU에서 28개 DiT 블록 전체를 통과하는 forward 한 번의 순수 추론 시간 합계는 약 38.90초다. 아래 분기별 값은 각각 28개 블록의 실행 시간을 합산한 값이다.

    각 코어별 세부 소요 시간은 다음과 같다: – Self-Attention Core: 12.99초 – Cross-Attention Core: 3.92초 – FFN Core: 21.99초

    ROCK 5C의 28블록 전체 DiT forward 한 번에서 분기별 NPU 추론 시간 합계. 1: self-attention, 2: cross-attention, 3: FFN. 단일 블록 시간이 아니다.
    ROCK 5C의 28블록 전체 DiT forward 한 번에서 분기별 NPU 추론 시간 합계. 1: self-attention, 2: cross-attention, 3: FFN. 단일 블록 시간이 아니다.

    파라미터 비중이 큰 FFN 코어가 전체 순수 NPU 추론 시간의 약 56.5%를 차지한다. 참고로 ONNX 수치 검증 로직이 동반된 28블록 전체 테스트의 전체 실행 시간(Wall Time)은 162.8초였으며, 이는 순수 NPU 연산 시간(38.90초)과 구분된다.

    20스텝 순차 CFG 디노이징 결과

    실제 이미지 생성 과정인 20스텝 순차 분류기 없는 가이던스(Sequential Classifier-Free Guidance, CFG, guidance scale 4.0) 디노이징을 보드에서 직접 수행했다. 조건부(Positive) 및 무조건부(Negative) 예측을 단일 배치로 묶지 않고 메모리 한계를 감안하여 순차 호출 방식으로 처리했다.

    • 20스텝 디노이징: 2,408.54초
    • 스텝당 평균: 120.40초
    • 스텝당 순수 NPU 연산: 76.21초
    • 스텝당 모델 준비·호스트 처리 등: 약 44.19초
    • 20스텝 전체 구간 NaN/Inf: 0건

    스텝당 약 44.19초의 비-NPU 시간에는 84개 RKNN 모델의 로드·초기화·해제(load/init/release)뿐 아니라 호스트 연산과 경계 처리 비용도 포함된다. 후속 최적화에서는 이 비용을 나누어 계측해야 한다.


    5. VAE를 바꿔 이미지 복원 시간 줄이기

    디노이징이 완료된 잠재 변수(Latent)를 512×512 픽셀 RGB 이미지로 복원하는 VAE 디코딩 과정은 CPU 연산 부담이 큰 단계다. 공식 Diffusers의 Qwen-Image VAE FP32 CPU 구현을 그대로 사용했을 때의 디코딩 시간은 2,154.51초(약 35분 54초)에 달해, 20스텝 DiT 디노이징 전체 시간과 맞먹는 심각한 병목을 유발했다.

    VAE 디코딩에는 stable-diffusion.cpp의 ARM NEON·OpenMP 최적화 CPU 구현을 적용했다. 텍스트 인코더와 트랜스포머를 다시 초기화하지 않고, 디노이징이 끝난 잠재 텐서만 받아 이미지로 복원하도록 연결했다.

    CPU 4스레드, 타일 크기 32×32, 오버랩 0.5 설정으로 측정한 VAE 백엔드 비교 결과는 다음과 같다:

    평가 지표 공식 Diffusers FP32 VAE sd-cpp 타일형 CPU VAE 개선폭
    디코딩 소요 시간 2,154.51초 155.04초 13.90배 단축 (1,999.47초 절감)
    PSNR (Diffusers 출력 대비) 기준 출력 31.444 dB 참조 출력과 비교
    11×11 Gaussian SSIM 1.00000 0.96109 참조 출력과 비교
    출력 해상도 및 규격 512×512 RGB 512×512 RGB NaN / Inf 0건

    육안 검토에서는 구성·색·세부 표현이 유지된 것으로 평가했다. PSNR과 SSIM은 두 출력이 완전히 동일하다는 뜻은 아니다. 디코딩 시간은 2분 35초 수준으로 단축했다.

    디노이징과 이미지 복원 시간 합계

    VAE 가속을 통합한 전체 이미지 생성 시간은 다음과 같다: – DiT 20스텝 순차 CFG 디노이징: 2,408.54초 – sd-cpp 타일형 VAE 디코딩: 155.04초 – 총 생성 시간 (프롬프트 1회 인코딩 제외): 2,563.58초 (약 42분 44초)


    6. 다음 병목은 디노이징

    VAE 디코딩 시간을 2,154.51초에서 155.04초로 단축함에 따라, 전체 파이프라인에서 VAE가 차지하는 비중은 기존 47.2%에서 6.0%로 대폭 축소되었다. 이에 따라 전체 시스템의 지배적 병목은 DiT 20스텝 디노이징(2,408.54초, 전체의 94.0%)으로 전환되었다.

    DiT 디노이징 내부를 분해하면, 순수 NPU 연산에 소요되는 시간은 스텝당 76.21초(20스텝 합계 1,524.20초)이며, 나머지 약 884.34초는 모델 수명주기와 호스트 처리 등을 포함한 비-NPU 시간이다. 컨텍스트 상주는 반복 초기화 비용을 줄이기 위한 후보였지만, 8GB 환경에서는 메모리 여유와 실제 절감량을 별도로 검증해야 했다. 그 실험 결과는 3편에서 다룬다.

    이후 최적화에서는 연산 횟수와 메모리 사용량을 함께 살펴봤다. 2편은 Spectrum으로 계산 스텝을 줄인 결과, 3편은 양자화와 모델 상주가 화질·메모리 제한에 부딪힌 결과를 다룬다. 4편에서는 컴파일러 버전 비교와 그래프 융합의 손익을 살펴본다.

  • 3.3V MCU 릴레이 구동 MOSFET 선정: 온저항·게이트 저항·내압 계산

    3.3V MCU 릴레이 구동 MOSFET 선정: 온저항·게이트 저항·내압 계산

    3.3V GPIO로 12V 릴레이를 제어할 때는 MOSFET의 문턱전압보다 실제 게이트 전압에서 보증된 온저항을 먼저 확인해야 한다. 전원과 코일 공차로 정해지는 부하 전류, 코일 차단 시 드레인 피크 전압, GPIO의 충·방전 전류를 함께 계산하면 부품 선정 근거가 분명해진다.

    아래는 특정 제품의 실측 결과가 아닌, 조건을 가정한 저속 DC 릴레이 ON/OFF 설계 예제다.

    1. VGS(th) 대신 보증 온저항을 확인하기

    AO3400A 데이터시트 Rev 3.1에서 문턱전압 VGS(th)는 드레인 전류 250µA, VDS=VGS 조건으로 정의된다. 최소·표준·최대값은 각각 0.65V·1.05V·1.45V다. 이 시험 전류는 문턱을 정의하는 도통 전류이며, 릴레이 부하 전류에서 낮은 온저항을 보증하는 조건이 아니다.

    제조사의 최대 온저항 규격은 다음과 같다. 표의 접합부 온도 조건은 TJ=25°C다.

    게이트 전압 VGS 시험 드레인 전류 최대 RDS(on)
    2.5V 3A 48mΩ
    4.5V 5A 32mΩ
    10V 5.7A 26.5mΩ

    3.3V MCU를 사용하더라도 GPIO의 High 출력이 항상 3.3V인 것은 아니다. MCU 데이터시트의 VOH 최소값과 부하 조건을 확인하고, 게이트 저항망의 전압 강하와 소스 전압 변동을 반영한 VGS가 온저항 규격의 시험 전압보다 충분히 높은지 확인해야 한다. 온저항 표의 시험 전류를 실제 PCB에서 허용되는 연속 전류로 해석해서도 안 된다.

    출처: AO3400A 공식 데이터시트, 전기적 특성 및 열 특성 표.

    2. 코일 전류와 도통 손실 계산

    예제 조건은 다음처럼 가정한다. GPIO 값은 특정 MCU의 보증 사양이 아니다.

    항목 예제 가정
    공칭 코일 전압·저항 12V·120Ω
    최대 공급전압 13.2V
    저온과 공차를 고려한 최소 코일 저항 108Ω
    GPIO VOH 최소값 2.9V
    게이트 충전 전류 예산 4mA
    계산에 사용할 온저항 48mΩ, VGS=2.5V·TJ=25°C 규격

    공칭 전류는 12V/120Ω=100mA이고, 가정한 최대 전류는 다음과 같다.

    \[I_{coil,max}=\frac{13.2}{108}\approx0.12222\ \mathrm{A}\]

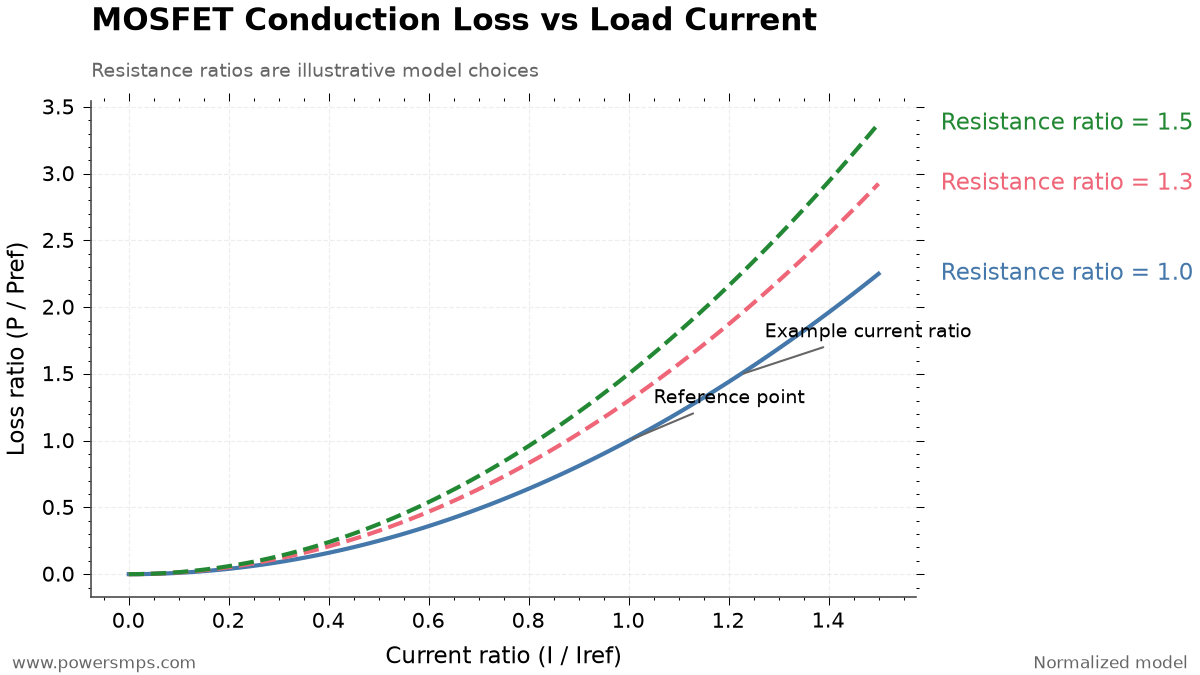
    도통 손실은 전류의 제곱에 비례한다.

    \[P_{cond}=I_{coil}^{2}R_{DS(on)}\]

    공칭 전류에서의 계산값은 0.100²×0.048=0.00048W, 즉 0.48mW다. 최대 전류 가정에서는 약 0.12222²×0.048=0.000717W, 즉 0.717mW다.

    이 값은 25°C 온저항을 적용한 도통 손실 계산이다. 고온의 온저항 증가, 스위칭 손실, 실제 PCB 방열 조건을 포함한 최종 온도 보증값은 아니다. 데이터시트 열 특성은 2oz 구리를 사용한 1in² FR4 기판과 무풍 환경을 기준으로 하므로 실제 기판 조건을 별도로 확인해야 한다.

    전류 비율과 온저항 비율에 따른 정규화 도통 손실. 저항 배율 1.0·1.3·1.5는 비교를 위한 가정이며 특정 온도에서 보증된 값이 아닙니다.
    전류 비율과 온저항 비율에 따른 정규화 도통 손실. 저항 배율 1.0·1.3·1.5는 비교를 위한 가정이며 특정 온도에서 보증된 값이 아닙니다.

    그래프의 저항 배율 1.0·1.3·1.5는 비교를 위해 선택한 모델 값이다. 특정 온도에 대응하는 제조사 보증값이나 실측 데이터가 아니다. 같은 온저항에서는 전류가 1.2배가 될 때 도통 손실이 1.44배가 되는 관계를 보여준다.

    3. GPIO·게이트·릴레이의 연결 조건

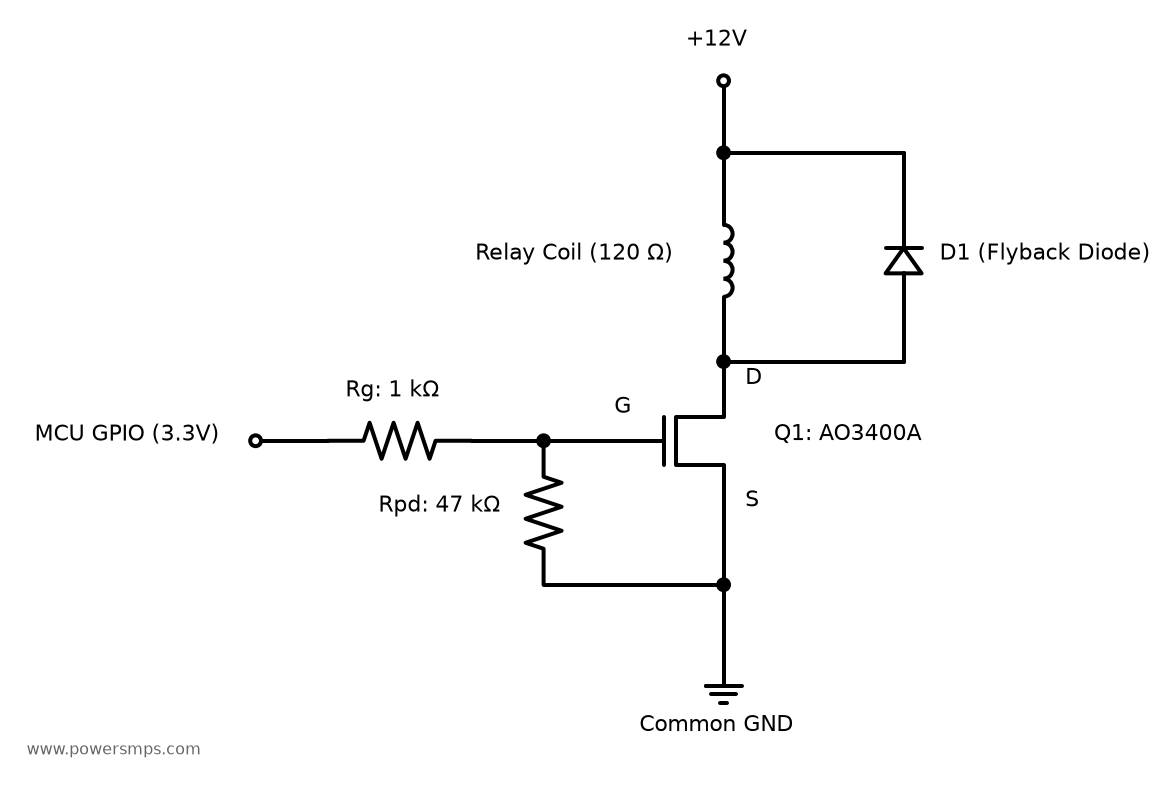
    3.3V GPIO, 1kΩ 게이트 저항, 47kΩ 풀다운, AO3400A MOSFET으로 12V 릴레이를 구동하는 회로. 코일 양단에 플라이백 다이오드를 연결하고 접지를 공통으로 사용합니다.
    12V·120Ω 릴레이 코일의 로우사이드 구동 예. 플라이백 다이오드의 캐소드는 +12V에 연결합니다. 부품값은 본문의 선정 조건과 함께 확인하세요.

    예제는 MCU와 부하 전원이 공통 접지를 공유하는 로우사이드 N-MOSFET 회로다. 연결은 다음 표와 같다.

    소자·노드 연결
    릴레이 코일 +12V와 Q1 드레인 사이
    Q1 소스 MCU와 공유하는 공통 GND
    직렬 게이트 저항 Rg GPIO와 Q1 게이트 사이, 예제값 1kΩ
    풀다운 저항 Rpd Rg 뒤쪽의 Q1 게이트와 소스 사이, 예제값 47kΩ
    플라이백 다이오드 D1 캐소드가 +12V, 애노드가 Q1 드레인

    로우사이드 N-MOSFET의 바디 다이오드는 소스에서 드레인 방향이다. 코일 차단 시 드레인이 전원보다 높은 양의 전압으로 상승하면 바디 다이오드는 역바이어스되므로 코일의 플라이백 환류 경로를 대체하지 못한다.

    다이오드 정격과 릴레이 복귀 시간의 관계는 기존 릴레이 플라이백 다이오드 선정과 차단 시간 계산에서 이어서 확인할 수 있다.

    4. 직렬 게이트 저항과 풀다운 계산

    GPIO를 이상적인 3.3V 전압원으로 보고 초기 게이트 충전 전류 예산을 4mA로 정하면, 외부 직렬 저항의 하한 계산은 3.3V/4mA=825Ω이다. 예제에서는 1kΩ를 선택한다. GPIO 내부 출력 저항을 무시한 계산에서 초기 전류 상한은 3.3V/1kΩ=3.3mA다. 실제 부품 선정에는 MCU의 권장 source·sink 전류와 VOH·VOL 조건을 각각 대조해야 한다. 절대 최대 정격 전류를 상시 구동 목표로 사용하지 않는다.

    게이트 뒤쪽에 47kΩ 풀다운을 연결하면 정상상태에서 분압이 발생한다. VOH 최소값 2.9V, 게이트 누설 무시, 소스 전압 바운스가 없는 공통 접지 조건에서는 다음과 같다.

    \[V_{GS}=2.9\times\frac{47}{1+47}\approx2.8396\ \mathrm{V}\]

    이 DC 가정에서는 2.5V 온저항 규격의 시험 전압보다 높다. 실제 회로에서도 온도·전원 공차·소스 전압 변동을 포함한 여유를 확인해야 한다. GPIO를 3.3V로 두었을 때 저항망으로 흐르는 DC 전류는 3.3V/48kΩ=68.75µA다.

    리셋 중 GPIO가 High-Z일 때를 위한 정적 계산도 가능하다. 총 누설 전류를 1µA, 허용 게이트 전압을 0.3V로 가정하면 Rpd≤0.3V/1µA=300kΩ이다. 47kΩ에서는 정적 누설 전압이 약 47mV다. 풀다운은 게이트 가까이에 배치하되, 이 계산이 급격한 드레인 전압 변화에 의한 밀러 유입 전류나 모든 전원 인가 순서에서의 오도통 방지를 보증하는 것은 아니다.

    5. 코일 클램프를 포함한 MOSFET 내압 계산

    AO3400A의 VDS 절대 최대 정격은 30V다. 선정 시에는 다음 전압 합에 설계 여유가 있어야 한다.

    \[V_{sup,max}+V_{clamp,max}+V_{overshoot} < V_{DS,rating}\]

    일반 다이오드의 클램프 전압을 1V, 배선 오버슈트를 3V로 가정하면 피크는 13.2+1+3=17.2V다. 이는 30V보다 낮지만, 가정한 전압 합을 확인한 것이므로 실제 드레인 파형과 부품 공차를 검증해야 한다.

    반대로 24V 제너와 순방향 전압 0.8V 다이오드를 조합하는 가정에서는 오버슈트가 없어도 13.2+24+0.8=38V다. 따라서 이 조건에 30V AO3400A를 적용할 수 없다. 더 높은 내압 소자를 선정할 때도 제너의 실제 클램프 전류·온도·공차와 배선 서지를 포함해 판단해야 한다. 공급전압만 보고 MOSFET 내압을 고르면 이 차이를 놓치기 쉽다.

    6. 저속 ON/OFF와 PWM을 구분해 검증하기

    AO3400A의 총 게이트 전하 Qg는 표준 6nC·최대 7nC이지만, 시험 조건은 VGS=4.5V·VDS=15V·ID=5.7A다. 이를 3.3V 구동에서 보증된 전하량으로 사용하면 안 된다. 또한 Qg/Ig는 거친 충전 시간 추정이며 밀러 플래토를 포함한 실제 드레인 천이 시간과 같지 않다. 관련 원리는 TI SLUA618A 게이트 드라이버 설계 문서를 참고할 수 있다.

    저속 릴레이 ON/OFF용 저항값을 고속 PWM 솔레노이드 회로에 그대로 적용하지 않는다. 전용 드라이버의 필요 여부는 게이트 전하, GPIO의 source·sink 능력, 스위칭 손실, 온도와 EMI 예산을 함께 검토해 결정한다.

    최종 확인 순서는 다음과 같다.

    1. 실제 부품의 코일 공차와 공급전압 범위로 최대 전류를 다시 계산한다.
    2. 정상 동작 중 게이트-소스 전압이 온저항 보증 조건을 만족하는지 측정한다.
    3. 부팅·리셋·전원 인가 순서에서 게이트 오도통과 소스 전압 바운스를 확인한다.
    4. 코일 차단 시 드레인 피크와 링잉이 선정한 내압 여유 안에 있는지 확인한다.
    5. 실제 PCB와 사용 온도에서 발열을 확인한다.

    핵심은 실제 VGS에서 보증된 온저항 확인 → 최대 코일 전류와 손실 계산 → 게이트 저항망 검증 → 클램프를 포함한 VDS 검증의 순서다. 예제의 1kΩ·47kΩ는 이 조건에서 계산한 출발점이며, 적용할 MCU와 릴레이의 데이터시트로 다시 확인해야 한다.