목차
RK3688 비교를 준비하는 이유
RK3688을 기다리는 이유는 단순하다. ROCK 5C에서 오래 걸리던 이미지 생성이 새 보드에서는 얼마나 가벼워질지 궁금하기 때문이다. 칩 소식을 살펴보는 김에, 그동안 쌓아 둔 실측 기록도 다시 꺼내 봤다.
2026년 10월 27일 현재 나는 RK3688 장비를 구입할 계획을 세우고 있다. 지금까지 직접 돌려 본 ROCK 5C의 기록을 출발점으로 삼아, 새 장비를 들였을 때 비교해 보고 싶은 것들을 정리했다.
RK3688은 언제 만나 볼 수 있을까
최근 소식을 따라가면서 내 눈에 들어온 것은 제품의 순서다. Rockchip의 공시와 Radxa 쪽 자료를 함께 보면, 먼저 나올 보드와 조금 더 기다려 볼 보드의 윤곽을 생각해 볼 수 있다.
Rockchip은 Rockchip 2026년 3분기 분기보고서에서 RK3668을 곧 생산에 투입하고 RK3688을 뒤이어 내놓겠다고 설명했다. 내가 기다리는 RK3688에 앞서 RK3668이 시장에 먼저 모습을 드러내는 흐름이다.
Radxa 공식 다운로드 서버 rock6/6b 디렉터리에서 찾은 Rockchip RK3668 SoC Application REL02도 흥미롭다. 2026-10-09자 문서에는 RK3668의 CPU가 6개의 Cortex-A725와 2개의 Cortex-A520으로 구성되고, NPU는 44 TOPS Sparse, 엔지니어링 샘플은 2027년 1분기로 적혀 있다.
특히 문서가 rock6/6b 폴더에 올라와 있다는 점이 눈에 띈다. 개인적으로는 ROCK 6 계열에서 어떤 칩과 메모리 구성을 만나게 될지 기대하게 된다. SBC에 이어 확장성이 좋은 보드까지 선택지가 이어지면 더 반가울 것 같다.
Rockchip도 Rockchip 공식 고성능 SoC 로드맵 발표에서 RK3668과 RK3688을 다음 고성능 플랫폼으로 소개했다. 나는 이 두 칩이 RK3588 계열을 쓰던 사람에게 어떤 업그레이드 선택지가 될지 관심 있게 보고 있다.
일정을 보고 내가 예상하는 그림은 RK3668 쪽 보드가 먼저 나오고, RK3688 보드가 그 뒤를 잇는 모습이다. 개인적으로는 당장의 판매일을 좇기보다 내년에 실제로 살 수 있는 보드가 나오는지 지켜보는 쪽에 무게를 둔다. 출시 소식만큼 SDK와 메모리 구성도 기대하고 있다.
RK3588과 RK3688, 얼마나 빨라질까
사양으로 그려 보는 RK3588과 RK3688의 차이
먼저 내가 기다리는 성능 차이부터 정리해 봤다. RK3688 쪽은 2025년 Rockchip 개발자 행사에서 공개된 사양 슬라이드를 바탕으로 한 계획 사양이다. 지금 쓰는 ROCK 5C의 RK3588S2 구성과 나란히 놓으면 왜 업그레이드를 기대하는지 더 잘 보인다.

| 항목 | 현재 RK3588 계열·ROCK 5C | RK3688 공개 계획 | 내가 기대하는 변화 |
|---|---|---|---|
| CPU 구성 | 4×Cortex-A76 + 4×Cortex-A55, 8코어 | 8×Cortex-A730 + 4×Cortex-A530, 12코어 | 전체 코어 1.5배, 큰 코어 2배로 병렬 작업 여유 |
| CPU 정수 처리량 | 자료의 참고값 93K DMIPS | 300K DMIPS 이상 | 참고값 대비 약 3.2배 규모의 처리량 |
| NPU | 6 TOPS(INT8) | RKNN-P3, 32 TOPS 이상 | 명목 최고 연산량 약 5.3배, 실제 모델에서의 가속 기대 |
| GPU | Mali-G610 MC4 | Mali-Magni, 2.0 TFLOPS 이상 | 그래픽과 GPU 연산의 여유 증가 기대 |
| 메모리 | 내 보드 8GB LPDDR4x | LPDDR5/5x/6, 최대 200GB/s 계획 | 큰 모델 적재와 데이터 이동의 숨통이 트이길 기대 |
CPU는 코어 수뿐 아니라 세대도 크게 바뀐다. 내가 조사한 RK3588의 93K DMIPS와 RK3688 계획의 300K DMIPS를 놓으면 약 3.2배다. 나는 이 차이가 CPU가 맡는 전후처리와 여러 작업을 동시에 돌릴 때 특히 반가울 것으로 본다. 단일 스레드 속도나 VAE 시간이 같은 배수로 바뀌는지는 실제 작업에서 따로 살펴볼 부분이다.
NPU의 6→32 TOPS는 약 5.3배다. 숫자만 보면 가장 기대되는 부분이지만, 내가 쓰는 Anima는 FP16 DiT와 CPU 처리가 섞여 있다. 그래서 아래 시간 전망에서는 INT8 TOPS 배수를 그대로 쓰는 대신, 데이터 이동과 CPU 처리를 포함한 디노이징 단계 전체가 얼마나 빨라질지를 따로 가정했다. GPU는 세대 변화와 2.0 TFLOPS 이상이라는 목표를 보고 기대하고 있다.
메모리도 내게는 중요한 업그레이드 이유다. 지금의 8GB LPDDR4x 환경에서 더 빠른 메모리와 넉넉한 용량을 갖춘 보드로 넘어간다면 모델 적재와 반복 실행이 한결 편해질 것으로 기대한다. 최대 200GB/s는 조사 자료의 칩 계획값이므로, 구입할 보드의 실제 메모리 구성도 유심히 볼 생각이다.
지금 보드에서 쌓인 실제 사용 기록
비교의 출발점은 내가 운용했던 ROCK 5C 8GB다. 새 보드를 기다리는 동안 기존 환경이 어디에서 시간을 쓰고 얼마나 뜨거워졌는지부터 다시 살펴봤다.
내가 사용한 보드는 Radxa 공식 ROCK 5C 문서의 표준판인 RK3588S2 모델이며 메모리는 8GB다. 소프트웨어에서는 런타임 타깃을 rk3588로 지정한다. Lite 모델에는 RK3582가 들어가므로 보드 이름과 칩 이름을 함께 적어 두었다.
실측에 사용한 작업은 앞서 ROCK 5C 8GB의 RKNN 변환과 실행 결과에서 다룬 512×512 Anima 이미지 생성이다. NPU와 CPU가 다음처럼 일을 나눠 처리한다.
| 파이프라인 단계 | 처리 장치 | 역할 |
|---|---|---|
| 텍스트 인코딩 | CPU | 프롬프트 컨텍스트 생성 |
| DiT attention·FFN | NPU | 분할한 FP16 RKNN 그래프 실행 |
| 정규화·게이트·잔차 처리 | CPU | 호스트 연산과 FP32 잔차 누적 |
| VAE 디코딩 | CPU | 잠재 표현을 최종 이미지로 복원 |
2026년 8월 13일부터 8월 25일까지 수집된 원본 작업 로그를 전수 재집계한 결과, 총 649회의 생성 작업 시도 중 정상 완료 404건, 작업 실패 245건으로 집계되었다. 정상 완료된 404건 작업의 세부 소요 시간 분포는 다음과 같다.
- 평균 소요 시간: 1658.52초 (약 27.64분)
- 중앙값: 1627.29초 (약 27.12분)
- 최소 소요 시간: 1513.56초 (약 25.23분)
- 최대 소요 시간: 1911.67초 (약 31.86분)
- 95백분위수 (p95): 1799.59초 (약 29.99분)
완료한 404건 중 30분을 넘긴 작업은 20건, 약 4.95%였다. 여러 스텝 설정을 번갈아 쓰던 시기의 기록이라, 내게 한 장 평균 27.64분은 당시 사용 속도를 떠올리게 하는 숫자다. RK3688에서는 같은 스텝 조건을 맞췄을 때 대기 시간이 얼마나 줄어들지 보고 싶다. 245건의 실패 시도도 함께 남아 있어, 새 장비에서는 완료 시간과 실패 양상을 같이 살펴볼 생각이다.
센서 7002개로 본 온도와 NPU 클럭
속도와 함께 다시 본 것은 온도다. 2026년 8월 20일부터 8월 25일까지 약 1분 간격으로 쌓인 센서 샘플 7002개를 모아 보니, 보드 각 부위의 온도 변화가 꽤 선명하게 보였다.
7002개 센서 샘플 전체에서 확인된 온도 센서 존별 주요 통계는 다음과 같다.
| 센서 존 (Zone) | 평균 온도 (°C) | 중앙값 (°C) | 95백분위수 (°C) | 관측 최고 온도 (°C) |
|---|---|---|---|---|
bigcore0-thermal |
40.22 | 39.77 | 59.15 | 75.77 |
bigcore1-thermal |
40.37 | 39.77 | 59.15 | 75.77 |
littlecore-thermal |
39.72 | 38.85 | 56.38 | 70.23 |
soc-thermal |
39.19 | 38.85 | 54.54 | 69.31 |
npu-thermal |
38.21 | 37.92 | 51.77 | 64.69 |
center-thermal |
38.00 | 37.92 | 50.85 | 63.77 |
gpu-thermal |
37.35 | 37.00 | 49.00 | 61.00 |
측정 환경: 실내 운용 로그의 온보드 센서값. 당시 주위 온도와 방열판·팬의 세부 설정은 미기록.
내가 좋게 본 부분은 NPU 클럭이다. 수집한 7002개 샘플에서는 rknpu_ondemand 환경의 주파수가 1,000,000,000 Hz, 즉 1.0 GHz로 유지됐다. 센서별 최고 온도는 각각의 시점에 기록된 값이다. 새 장비에서는 이 기록에 코어별 부하도 더해, 추론이 돌아가는 모습을 좀 더 자세히 보고 싶다.
온도 변화는 그래프로 보는 편이 더 와닿는다. 아래는 bigcore0가 최고 75.769°C를 기록한 시점의 전후 15분에서 고른 30개 샘플이다.
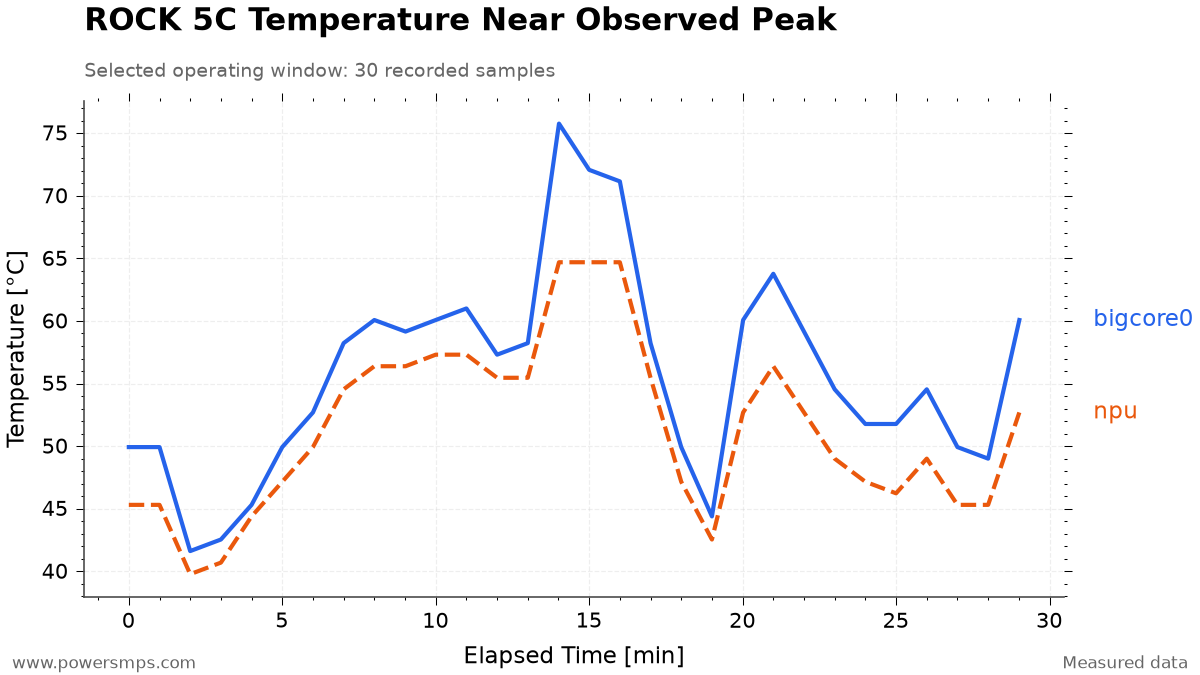
bigcore0 온도는 50°C 안팎을 유지하다가 14분 시점에 최고 75.769°C까지 상승한 후, 18분 시점에 49.923°C로 하강하는 동적 특성을 보였다. 동일 구간에서 NPU 온도는 14분부터 16분 사이에 걸쳐 최고 64.692°C를 유지한 뒤 점진적으로 냉각되었다.
내 눈에는 온도가 한 수준에 머무르기보다 작업 흐름을 따라 오르내리는 모습이 먼저 들어온다. RK3688에서도 이 곡선이 어떻게 달라질지 궁금하다. 더 짧아진 대기 시간과 함께, 방열판이나 팬을 어느 정도로 준비하면 편하게 쓸 수 있을지도 직접 확인해 보고 싶다.
단일 MatMul과 전체 추론 성능의 차이
Radxa ROCK 5C(RK3588 런타임 타깃, RKNPU 드라이버 0.9.8, RKNN Runtime 2.3.2) 환경에서 Anima DiT FFN 블록의 주요 형상(Linear 1: M=1024, K=2048, N=8192 / Linear 2: M=1024, K=8192, N=2048, 각 34.36 GOP)을 대상으로 RKNN MatMul C API 단일 코어 벤치마크를 수행한 결과는 다음과 같다.
| 연산 경로 및 정밀도 | Linear 1 지연 시간 | Linear 2 지연 시간 | 두 연산 합계 | FP16 대비 배속 |
|---|---|---|---|---|
| FP16 x FP16 -> FP16 | 51.89 ms | 460.61 ms | 512.50 ms | 1.00x |
| INT8 x INT8 -> INT8 | 19.13 ms | 115.67 ms | 134.80 ms | 3.80x |
| FP16 x FP16 -> FP32 | 57.93 ms | 463.10 ms | 521.03 ms | 1.00x |
| INT8 x INT8 -> INT32 | 100.80 ms | 118.32 ms | 219.12 ms | 2.38x |
이 표에서 내가 눈여겨본 것은 두 번째 Linear다. 두 연산이 각각 34.36 GOP인데도 차원을 줄이는 Linear 2의 FP16 실행에는 460.61 ms가 걸렸다. INT8 입출력 경로의 합계는 FP16보다 약 3.80배, INT32 출력 경로의 비교에서는 약 2.38배 빨랐다. 같은 보드에서도 연산 형상과 정밀도에 따라 체감 속도가 크게 달라질 수 있다는 점이 흥미로웠다.
당시 실험에서는 W8A16 형식인 RKNN_FLOAT16_MM_INT8_TO_FLOAT32와 RKNN_FLOAT16_MM_INT8_TO_FLOAT16의 context 생성이 거부됐다. MatMul API에 core_mask=7을 요청했을 때는 단일 코어 auto fallback으로 실행됐고, INT8 실행에는 failed to update out cvt offset! 경고도 남았다. 이런 경험 때문에 새 보드에서도 지원 정밀도와 실제 코어 설정을 먼저 살펴볼 생각이다.
속도보다 더 신경 쓰였던 것은 결과물이었다. W8A8 화질 실패와 8GB 상주 실험에서 FFN Linear W8A8을 적용한 이미지는 육안으로 봤을 때 만족스럽지 않아 FP16 구성으로 돌아갔다. RKNN Toolkit 2.3.2와 2.3.0 비교에서도 툴체인에 따른 차이를 경험했다. 그래서 RK3688에서 내가 가장 궁금한 것은 TOPS 숫자 자체보다, 지금 쓰는 모델의 화질을 유지하면서 얼마나 빨라질 수 있느냐다.
RK3688 구입 후 반복할 다섯 가지 시험
장비를 구입하면 아래 다섯 가지를 두 보드에서 차례로 돌려 볼 생각이다. 같은 조건에서의 비교와 각 보드에 맞춘 최적화를 함께 해 보면, 실제로 쓰기 좋은 구성이 더 잘 보일 것 같다.
모델과 입력, 정밀도, 해상도, 스텝수와 시드는 먼저 맞춰 둔다. 보드·메모리·SDK 버전과 냉각 환경도 함께 적어 두면 나중에 결과를 다시 보기 편하다.
| 해 볼 작업 | 내가 보고 싶은 것 |
|---|---|
| 유휴 상태 | 아무 작업이 없을 때의 온도와 클럭, 계측기를 준비한 뒤의 대기 전력 |
| CPU 전체 코어 부하 | 같은 스레드 수의 처리량 비교와 각 보드 전체 코어 부하를 나눠 보고, 유지 클럭과 온도를 함께 기록 |
| NPU 단일 연산 | 같은 형상·정밀도에서 실행 시간과 출력 차이, 실제 수락된 코어 설정 확인 |
| Anima 전체 추론 | 모델 로드·인코딩·디노이징·VAE를 포함한 대기 시간, cold와 warm 실행 비교 |
| 장시간 반복 운용 | 완료·실패 횟수, p50/p95 시간, 메모리·스왑과 온도·클럭의 변화 |
전력계를 준비하면 작업 중 소비전력도 시간에 따라 기록해 이미지 한 장에 든 에너지를 계산해 보고 싶다. 실행 파일의 해시는 보드별로 남기고, 원본 모델과 입력을 맞춰 비교할 계획이다.
Spectrum 최적화 기법처럼 보드에 맞춘 최적화는 따로 정리하려고 한다. 기본 조건에서의 차이와 실제로 가장 편하게 쓸 구성을 함께 보고 싶기 때문이다.
내가 기대하는 RK3688
25.20분 걸린 작업이 새 보드에서는 몇 분일까
여러 설정을 섞어 돌린 평균과 별도로, 단계별 시간이 남아 있는 Spectrum 20스텝 실험을 꺼냈다. 512×512, CFG 4.0, 시드 20260812 조건에서 FP16 DiT에 Spectrum을 적용하고 CPU VAE로 마무리했을 때, 디노이징은 1356.58초, VAE는 155.46초였다. 두 단계를 합하면 1512.04초, 약 25.20분이다. 아래 시간의 범위는 이 두 단계이며 프롬프트 인코딩과 모델 로드는 제외했다.
나는 이 25.20분이 RK3688에서 대략 7~13분으로 줄어들 수 있을지 기대하고 있다. 중심으로 잡은 예상은 9분 안팎이다. 디노이징 단계와 CPU VAE의 가속 폭을 다르게 놓고 계산하면 다음과 같다.
| 시나리오 | 디노이징 단계 가정 | CPU VAE 가정 | 두 단계 합계 |
|---|---|---|---|
| 현재 ROCK 5C 실측 | 1356.58초 | 155.46초 | 25.20분 |
| 조심스러운 기대 | 2배 빨라짐 | 1.5배 빨라짐 | 13.03분 예상 |
| 내가 기대하는 중간 | 3배 빨라짐 | 2배 빨라짐 | 8.83분 예상 |
| 잘 맞아떨어지는 경우 | 4배 빨라짐 | 2.5배 빨라짐 | 6.69분 예상 |
계산은 1356.58초 ÷ 디노이징 가속 배수 + 155.46초 ÷ VAE 가속 배수다. 예를 들어 디노이징 전체가 3배, CPU VAE가 2배 빨라지면 약 8.83분이 된다. 이 배수는 새 CPU·NPU·메모리 구성을 보고 내가 잡은 시나리오다. 특히 FP16 연산 지원과 RKNN 툴체인이 잘 맞아야 낙관적인 쪽에 가까워질 것으로 본다.
구입 후에는 같은 20스텝 설정으로 디노이징과 VAE 시간을 다시 기록해 이 예상표 옆에 붙일 생각이다. 나는 한 장에 9분 안팎까지 내려오기만 해도 프롬프트를 고쳐 가며 이미지를 만드는 흐름이 꽤 달라질 것 같다. 온도와 팬 소음까지 함께 좋아진다면 업그레이드 만족도는 더 높을 것이다.
나는 RK3688이 긴 이미지 생성의 대기 시간과 메모리 부담을 얼마나 덜어 줄지 기대하고 있다. 최고 성능뿐 아니라 온도와 소음, 반복 실행의 편안함까지 좋아진다면 업그레이드할 이유가 더 분명해질 것이다.
구입한 뒤에는 이 글에 처리 시간·화질·메모리·온도 결과를 차근차근 추가할 생각이다. 지금의 예상이 실제 사용에서도 맞아떨어지는지 확인하고, 세부 설정과 시행착오는 후속 글로 이어 가려고 한다.